Kanzlei-KI lokal auf einem Laptop von 2016: jede Antwort mit Fundstelle aus der Akte und ein ehrliches Nein, wenn dort nichts steht
Kurz gesagt
Ja, eine Kanzlei-KI läuft lokal auf einem Laptop von 2016 ohne Grafikkarte, wenn die Suche entscheidet und das Modell nur formuliert. In dieser Demo stellt die Kanzlei eine Frage an die Akte und bekommt eine Antwort nur mit anklickbarer Fundstelle. Steht nichts Passendes in der Akte, heißt es „In den Akten nicht gefunden“ statt einer Vermutung. Technik: Ollama mit qwen3:4b-instruct auf einem ThinkPad T460s, wahlweise über eine deutsche Modell-API. Gemessen am 16. Oktober 2026: Antwort mit Beleg in 12 bis 35 Sekunden, „nicht gefunden“ unter 0,2 Sekunden. Zwei Video-Lektionen zeigen Installation und Aktenfrage Schritt für Schritt. Alle Akten sind synthetisch: Namen, Aktenzeichen und Inhalte sind erfunden. Ob das in deiner Kanzlei trägt, klären wir im Erstgespräch.
Diese Seite anhören — 1:31 Min.
0:00 / 1:31 · Gesprochen von meiner geklonten KI-Stimme (ElevenLabs) — transparent gelabelt.
Transkript lesen
Kurz zusammengefasst: Eine Kanzlei-KI, die auf einem Laptop von 2016 läuft. Ohne Grafikkarte, ohne Cloud. Du stellst eine Frage an die Akte und bekommst eine Antwort nur mit Fundstelle. Ein Klick öffnet das Dokument genau an der belegten Stelle. So läuft es: Die Akten liegen als Textdateien auf dem Rechner. Eine klassische Suche findet die passenden Abschnitte. Erst dann bekommt das Sprachmodell drei Auszüge und darf nur daraus antworten. Jede Aussage trägt eine Nummer. Fehlt der Beleg, wird die Antwort verworfen. Kommen die Kernbegriffe der Frage in keiner Akte vor, sagt die Demo: In den Akten nicht gefunden. Das Modell wird dann gar nicht gefragt. Das Besondere: Alles ist gemessen. Eine Antwort mit Beleg dauert auf dem alten Laptop zwölf bis fünfunddreißig Sekunden. Das falsche Modell brauchte fast vier Minuten für einen Satz, das richtige siebzehn Sekunden. Gleicher Laptop, anderes Modell. Und die Akten werden auf diesem Rechner verarbeitet. Die Akten sind synthetisch, alle Namen erfunden. Zwei Video-Lektionen zeigen jeden Schritt. Ob so etwas in deiner Kanzlei läuft, klären wir in einem Erstgespräch auf heiner.io.
Was es bringt
Jede Aussage der Kanzlei-KI trägt eine Fundstelle, die in zwei Sekunden prüfbar ist: Die Antwort nennt Belegnummern, ein Klick öffnet das Dokument rechts genau an der belegenden Stelle, der Satz ist markiert. Vertrauen entsteht nicht, weil eine KI klug klingt, sondern weil der Beleg sofort sichtbar ist und die Kanzlei den Wortlaut selbst liest.
Ein ehrliches Nein statt einer erfundenen Antwort: Kommen die Kernbegriffe der Frage in keinem Abschnitt der Akte ausreichend vor, antwortet die Demo „In den Akten nicht gefunden“, und das Sprachmodell wird gar nicht gefragt. Im Modellbetrieb prüft die Demo zusätzlich jede Antwort und verwirft jede Aussage ohne gültige Belegnummer. Lieber kein Ergebnis als ein unbelegtes.
Der Betriebsweg ist jederzeit sichtbar: Oben in der Leiste steht, wo die Antwort entsteht, lokal auf diesem Rechner oder über IONOS beziehungsweise STACKIT in Deutschland. Der Wechsel ist eine Zeile in der Konfiguration; beide API-Wege sind vorbereitet, noch nicht getestet. Die Akten werden auf dem Kanzlei-Rechner verarbeitet, an eine Modell-API gehen nur die drei Auszüge der Fundstellen.
Alte Hardware reicht für den Anfang: Ein ThinkPad T460s von 2016 ohne Grafikkarte beantwortet Aktenfragen in 12 bis 35 Sekunden, gemessen am 16. Oktober 2026. Entscheidend war die Modellwahl, nicht der Rechner: Das Denkmodell qwen3:4b brauchte 3:58 Minuten für einen Satz, die Instruct-Fassung 17,6 Sekunden. Für eine Vorführung und einzelne Fragen reicht das, für mehrere Nutzer gleichzeitig nicht.
Das Problem — und die Lösung
Problem
Die meisten KI-Werkzeuge antworten auf jede Frage sofort, klingen überzeugend und verraten nicht, woher die Antwort stammt. In einer Kanzlei ist das unbrauchbar: Jede Aussage muss belegt sein, und wo Mandatsdaten verarbeitet werden, muss sichtbar sein, nicht Vertrauenssache.
Lösung
Eine kleine Demo trennt Suche und Modell: Die Suche findet die Abschnitte der Akte und entscheidet, ob überhaupt geantwortet wird. Das Sprachmodell bekommt nur nummerierte Auszüge und muss jede Aussage mit einer Nummer belegen. Die Akten werden auf dem Kanzlei-Rechner verarbeitet; der Betriebsweg steht sichtbar in der Leiste, lokal oder wahlweise über eine deutsche Modell-API.
13-mal schneller
derselbe Satz auf demselben Laptop: 3:58 Minuten mit dem Denkmodell qwen3:4b, 17,6 Sekunden mit qwen3:4b-instruct
Eigene Messung, ThinkPad T460s, Ollama 0.40.5 (16.10.2026)
Die Demo in drei Situationen: Beleg, ehrliches Nein, Aktenrechte
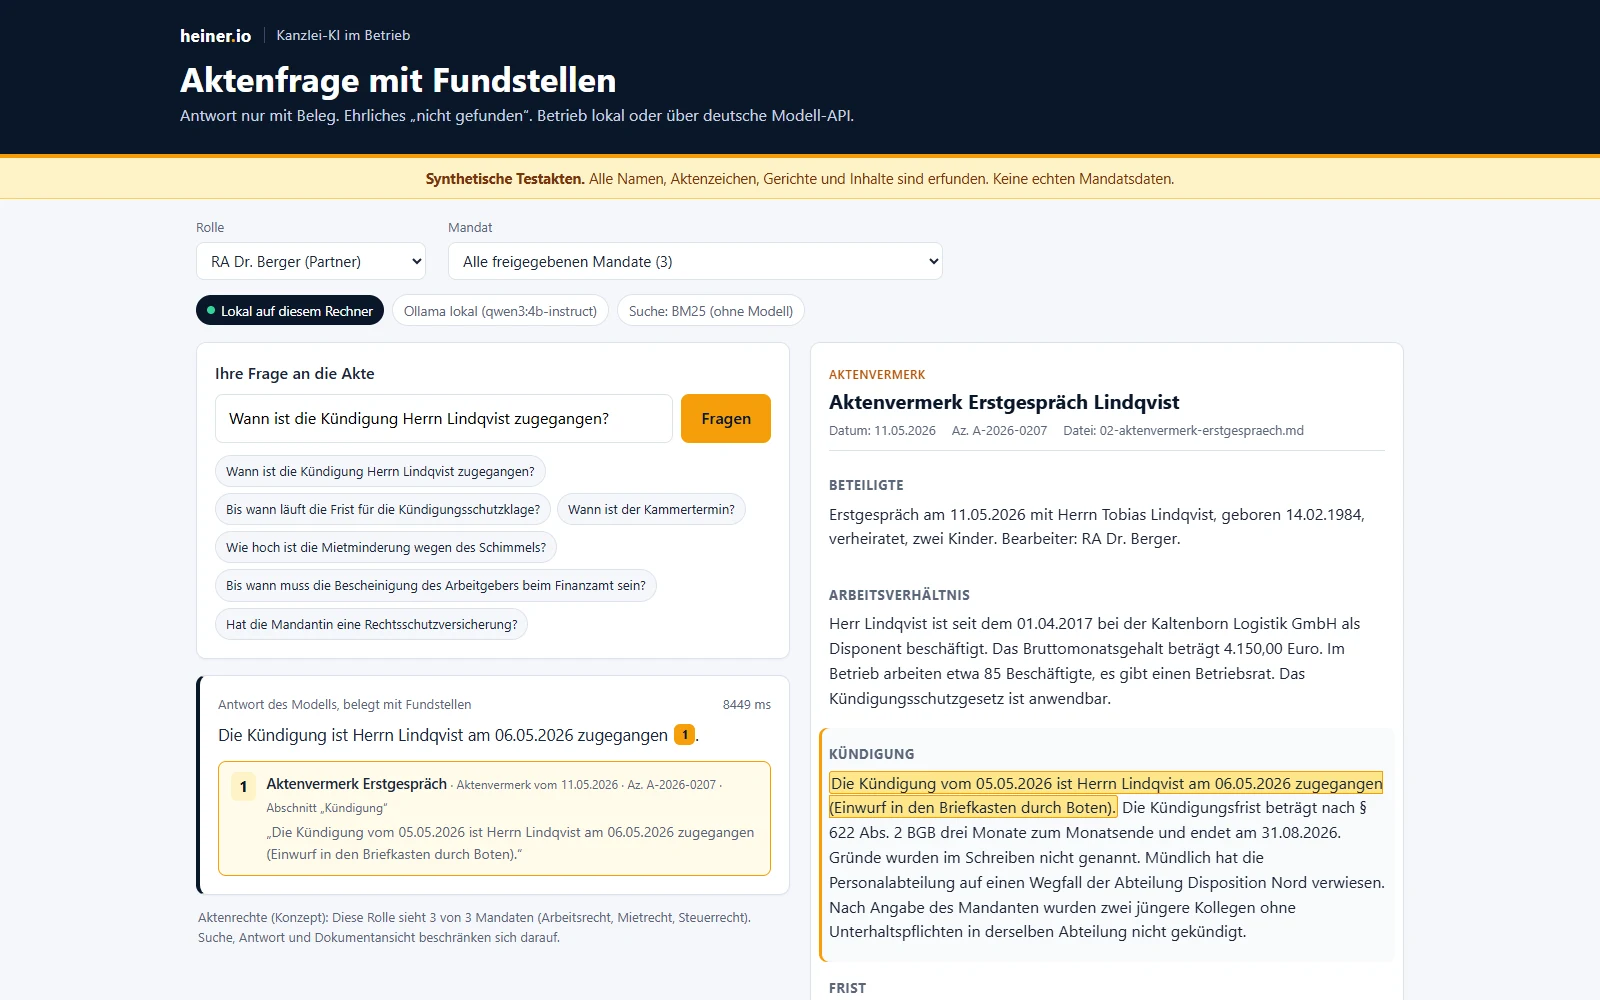
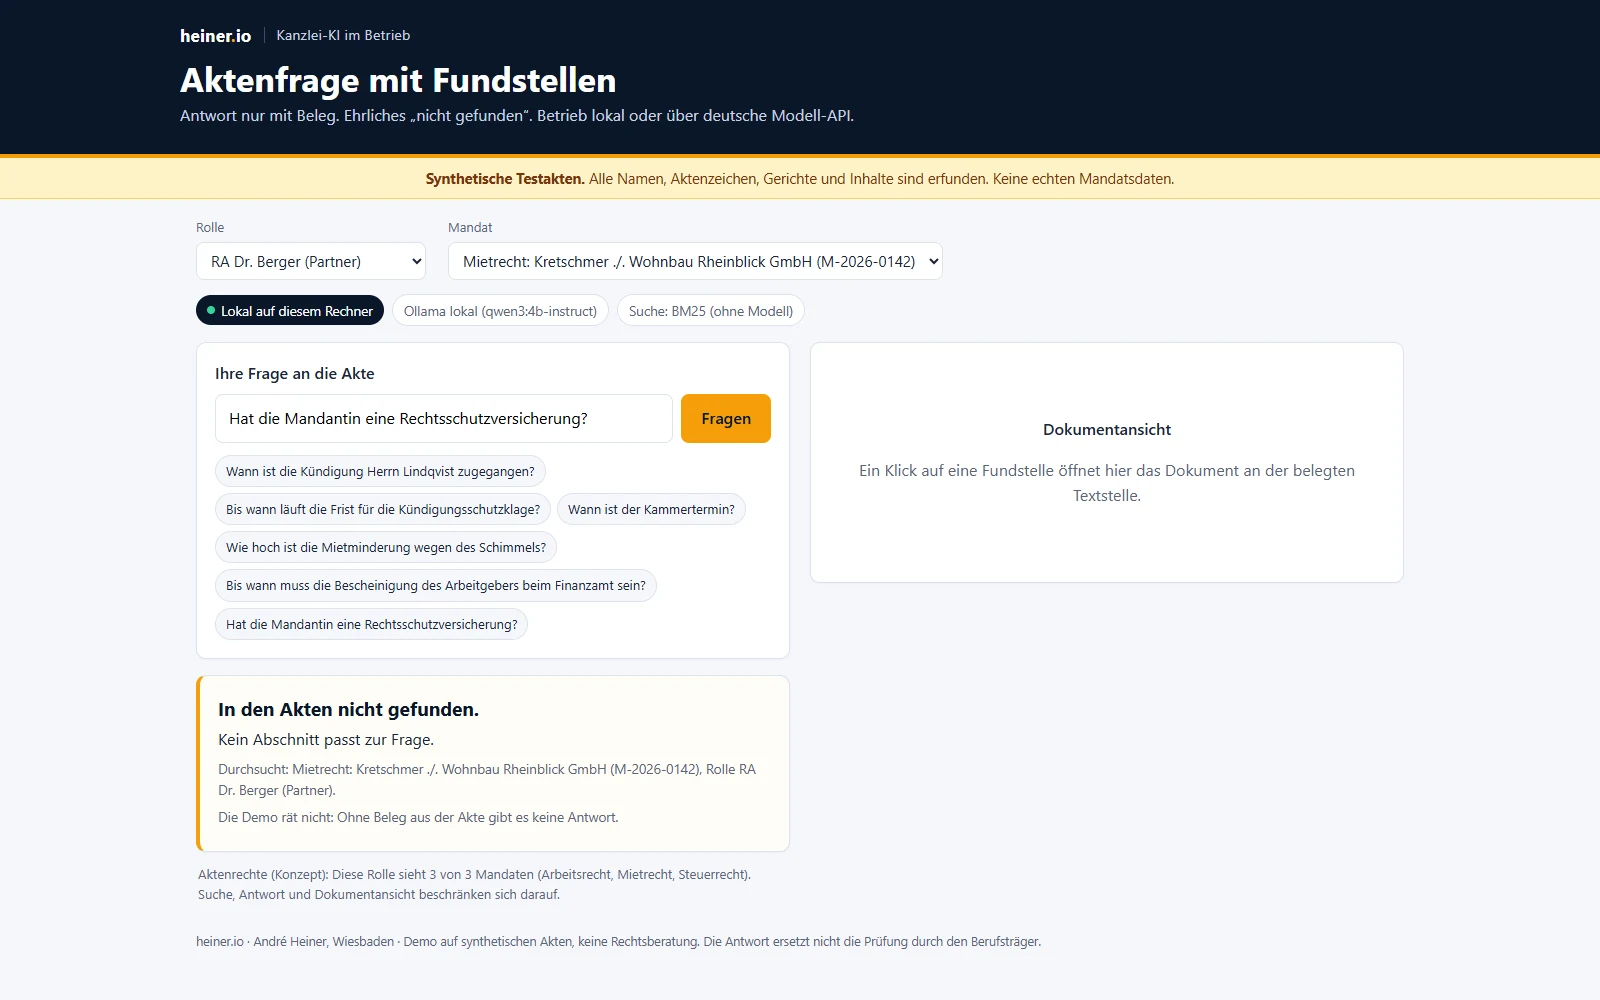
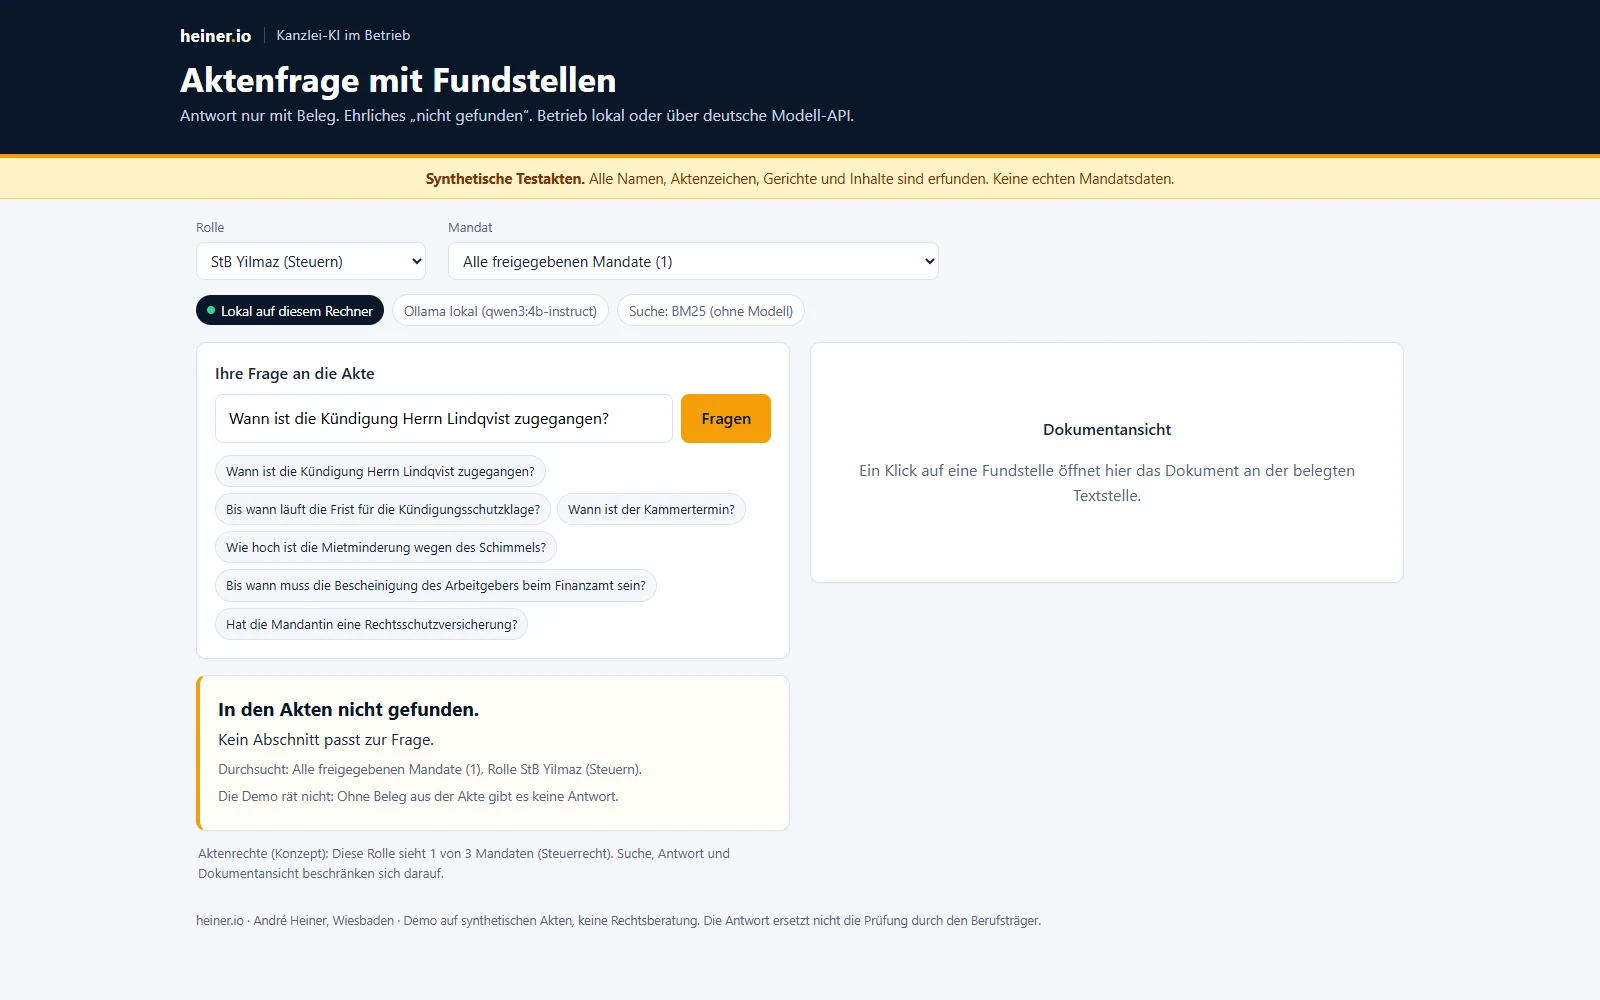
Antwort mit Beleg: Ein Klick auf die Nummer öffnet den Aktenvermerk, der belegende Satz ist markiert. Oben der Betriebsweg: lokal auf diesem Rechner. Die Akte ist synthetisch, der Name erfunden.
Aus der Praxis
Demo gebaut: Node.js ohne Abhängigkeiten, BM25-Suche, drei synthetische Mandate (Mietrecht, Arbeitsrecht, Steuerrecht) mit 16 erfundenen Dokumenten, fünf Testfragen mit erwarteter Fundstelle.
Überraschung live aufgezeichnet: Vor der Installation meldete der Test „5 von 5 bestanden“, obwohl kein Sprachmodell lief; die Demo hatte wörtliche Auszüge geliefert. Seitdem zählt der Test mit ANBIETER=ollama jede Antwort ohne Modell als Fehler.
Ollama live auf dem ThinkPad T460s installiert und gemessen: Installer 1,6 GB in rund 2,5 Minuten, je Modell 2,5 GB in rund 5 Minuten, erste Antwort mit qwen3:4b 3:58 Minuten, mit qwen3:4b-instruct 17,6 Sekunden.
Test mit Modell: 5 von 5 Fragen mit der erwarteten Fundstelle, Antwortzeiten 8,7 bis 34,1 Sekunden. Die Frage nach der Rechtsschutzversicherung endet sofort mit „nicht gefunden“, weil kein Abschnitt passt.
Zwei Video-Lektionen geschnitten (9:32 und 10:22 Minuten), Lippensynchronität aller Avatar-Szenen auf 0,0 Millisekunden gemessen. Die Veröffentlichung auf YouTube folgt; die Player auf dieser Seite sind vorbereitet.
Der Weg einer Aktenfrage durch die Demo
Dieses Board ist eine echte Obsidian-Canvas aus dem Projekt — gerendert im offenen JSON-Canvas-Standard. Zoomen, verschieben, Karten anfassen: erlaubt. Beim Neuladen ist alles wieder am Platz.
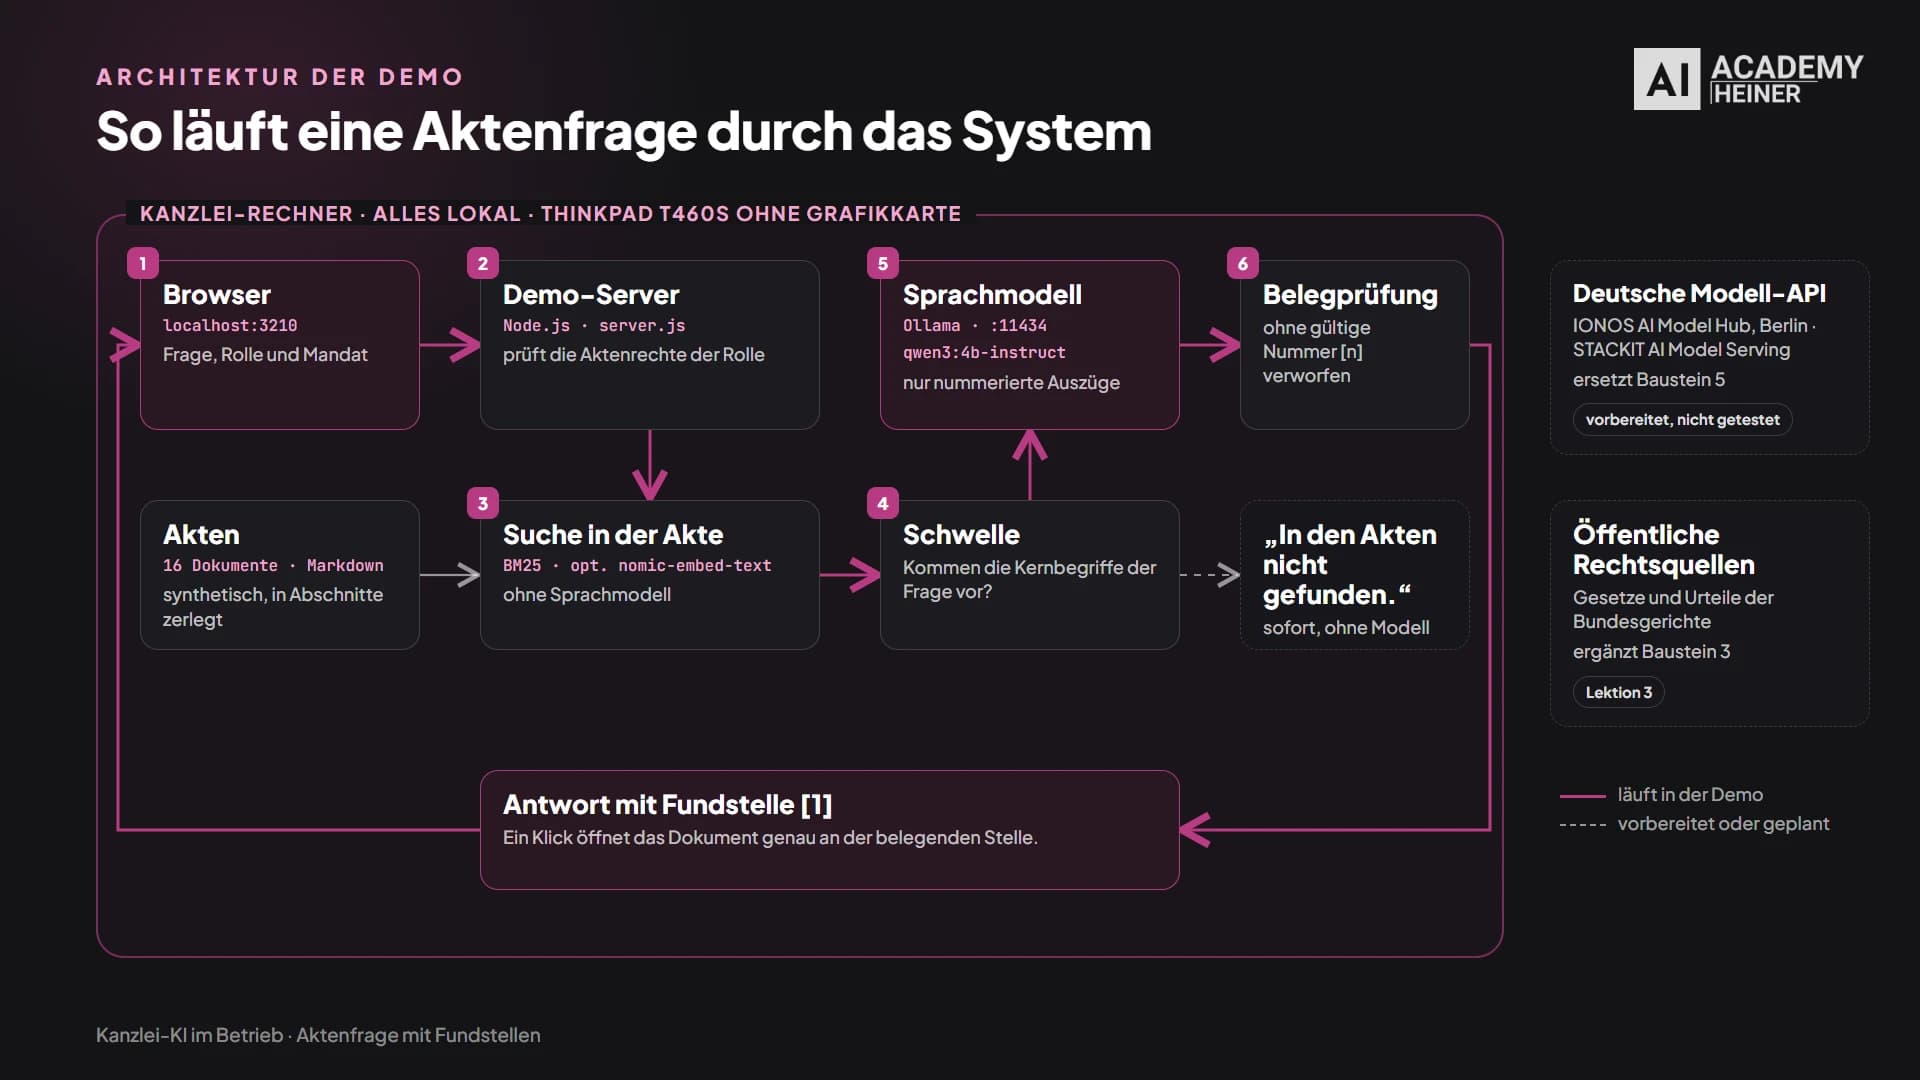
Ziehen, zoomen, Karten verschieben. Beim Neuladen ist alles wieder am Platz. Das Board zeigt den Weg einer Frage durch die Demo, genau wie das Schaubild in Lektion 2.
+Board-Inhalte als Text
- So läuft eine Aktenfrage durch das System — Kanzlei-Rechner, alles lokal: ThinkPad T460s von 2016, ohne Grafikkarte, 19 GB RAM
- 1 Browser — localhost:3210 — Frage, Rolle und Mandat eingeben
- 2 Demo-Server — Node.js, server.js, keine Abhängigkeiten — prüft die Aktenrechte der Rolle, bevor gesucht wird
- Akten — 3 Mandate, 16 Dokumente als Markdown — synthetisch: Namen, Aktenzeichen und Inhalte erfunden — in Abschnitte zerlegt
- 3 Suche in der Akte — BM25 mit deutscher Stammformbildung — optional nomic-embed-text (hybrid) — ohne Sprachmodell, unter 0,2 Sekunden
- 4 Schwelle — Kommen die Kernbegriffe der Frage — in einem Abschnitt ausreichend vor? — Wenn nicht: Stopp, das Modell wird nicht gefragt
- 5 Sprachmodell — Ollama auf Port 11434, qwen3:4b-instruct — bekommt nur 3 nummerierte Auszüge — und schreibt höchstens 120 Token
- 6 Belegprüfung — Aussage ohne gültige Nummer [n]? — Dann wird die Antwort verworfen.
- „In den Akten nicht gefunden.“ — sofort, ohne Modell — Die Demo rät nicht.
- Antwort mit Fundstelle [1] — Jede Aussage trägt eine Nummer. Ein Klick öffnet das Dokument rechts genau an der belegenden Stelle, der Satz ist markiert.
- Deutsche Modell-API — IONOS AI Model Hub (Berlin), STACKIT AI Model Serving — ersetzt Baustein 5, gleicher Schlüsselwechsel in .env — vorbereitet, nicht getestet
- Öffentliche Rechtsquellen — Gesetze und Urteile der Bundesgerichte — ergänzen Baustein 3 — Lektion 3, folgt
- Gemessen am 16.10.2026: Antwort mit Beleg 12 bis 35 Sekunden · „nicht gefunden“ unter 0,2 Sekunden · erste Frage nach dem Start plus 8 Sekunden Ladezeit · Thinking-Modell 3:58 Minuten, Instruct-Modell 17,6 Sekunden für denselben Satz
Die Lektionen im Video
Lektion 1: Lokale KI ohne Grafikkarte installieren
Ollama live auf dem ThinkPad von 2016: Modelle auf Laufwerk D statt C, zwei Modelle laden, die erste Antwort ehrlich gemessen. Dazu die Überraschung, die vier Minuten Wartezeit pro Satz spart.
- 00:00Ohne KI: die Demo vorher
- 00:38Für wen und warum
- 01:03In dieser Lektion
- 01:24Ziel und Aufbau der Demo
- 02:12Modelle im Überblick
- 02:31Vorher: der Test ohne Modell
- 03:10Modellordner auf D festlegen
- 03:51Herunterladen und installieren
- 05:10Zwei Modelle laden
- 06:06Die erste Antwort
- 07:09Das richtige Modell
- 07:50Die Demo mit Modell
- 08:38Fazit
+Transkript
Eine KI für Kanzleiakten. Auf einem Laptop von 2016. Ohne Cloud. Diese Kanzleidemo läuft gerade ohne KI. Oben steht es ehrlich: Auszug ohne Sprachmodell. Heute installiere ich ein Sprachmodell, lokal auf genau diesem Laptop. Ein ThinkPad von 2016 ohne eigene Grafikkarte. Zwei Fragen für die nächsten Minuten: Passt eine KI auf so einen Rechner, ohne dass Laufwerk C vollläuft? Und wie lange wartest du dann auf eine Antwort? Kurz zur Orientierung: Das hier ist Lektion eins der Reihe Kanzlei KI im Betrieb. Sie ist für Kanzleien, Rechtsanwälte, Steuerberater, Wirtschaftsprüfer und Notare. Warum lokal? Mandatsdaten unterliegen der Schweigepflicht. Wer KI einsetzt, muss wissen, wo diese Daten verarbeitet werden. Mit einem lokalen Sprachmodell passiert das auf dem eigenen Rechner, nicht in einer fremden Cloud. In dieser Lektion installiere ich Ollama, ein kostenloses Programm, mit dem Sprachmodelle auf deinem eigenen Rechner laufen. Du siehst, wie du die Modelle auf ein anderes Laufwerk legst, welche Modelle die Demo braucht, wie du prüfst, dass alles läuft und wie schnell die erste Antwort wirklich kommt. Ohne Konto, ohne Cloud, ohne Grafikkarte. Das Ziel der Reihe: Du stellst deiner Akte eine Frage und bekommst eine Antwort nur mit Fundstelle. Und wenn nichts in der Akte steht, ein ehrliches Nein. Die Akten in der Demo sind erfunden. Drei Mandate aus Mietrecht, Arbeitsrecht und Steuerrecht. So ist die Demo aufgebaut. Der Browser stellt die Frage, der Demo-Server sucht in der Akte und nur passende Auszüge gehen an das Sprachmodell. Am Ende prüft die Demo, ob jede Aussage einen Beleg hat. In dieser Lektion installieren wir Baustein fünf, das Sprachmodell, lokal mit Ollama. Später kommen öffentliche Quellen dazu. Gesetze und Urteile der Bundesgerichte, die frei im Netz stehen. Wie man sie nutzt und was dabei erlaubt ist, zeige ich in Lektion drei. Drei Bausteine kommen heute auf den Rechner. Ollama, kostenlos, führt die Modelle aus. Qwen drei von Alibaba Cloud schreibt die Antworten und Nomic Embed Text von Nomic hilft bei der Suche. Welche Qwen-Fassung auf einem alten Laptop taugt, zeigt sich in Kapitel sechs. Bevor ich etwas installiere, lasse ich den Test der Demo laufen. Fünf Beispielfragen an die Akten, jede mit der Stelle, an der die Antwort stehen muss. Ergebnis: Fünf von fünf bestanden. Moment, es ist doch noch gar kein Sprachmodell installiert. Die Antwort steht ganz unten, klein. Geprüft wurde nur der Auszugsmodus ohne Sprachmodell. Findet die Demo kein Modell, weicht sie auf wörtliche Auszüge aus der Akte aus. Die Antworten stimmen, aber nicht aus dem Grund, den ich prüfen wollte. Merk dir das. Ein grüner Test sagt nur, was er wirklich prüft. Erster Schritt und der kommt vor der Installation. Wo landen die Modelle? Ohne Einstellung im Benutzerordner auf Laufwerk C. Auf diesem Laptop ist C knapp, also lege ich die Modelle auf D. Dafür gibt es eine Umgebungsvariable mit dem Namen Ollama Models. Im Startmenü suchst du nach Umgebungsvariablen. Dann neu, Name und Ordner eintragen, zweimal OK. Wichtig: Die Variable gilt erst in neuen Fenstern. Deshalb setze ich sie vor der Installation und öffne das Terminal neu. Ollama startet direkt nach der Installation im Hintergrund und würde sonst den alten Ordner nehmen. Den Installer gibt es auf ollama.com unter Download für Windows. Voraussetzung laut Hersteller: Windows zehn in Version 22H2 oder neuer. Eine Grafikkarte braucht es nicht, Administratorrechte auch nicht. Die Datei ist gut anderthalb Gigabyte groß. Hier hat der Download zweieinhalb Minuten gedauert. Normalerweise würde ich jetzt doppelklicken. Dann installiert Ollama aber wieder in den Benutzerordner auf C. Ich starte den Installer deshalb aus dem Terminal mit dem Zusatz Schrägstrich dir und dem Zielordner D Ollama. Die Installation dauert hier rund fünf Minuten. Danach begrüßt dich Ollama und bietet ein Konto an. Brauchst du nicht. Unten steht, du willst Ollama lokal nutzen. Damit läuft Ollama im Hintergrund. Läuft es? Das prüfst du in zwei Sekunden. Im Browser: localhost:11434. Die Antwort: Ollama is running. Jetzt die Modelle. Ein neues Terminal, damit es Ollama findet und Ollama Version zeigt, dass alles da ist. Erstens, das Sprachmodell, das die Antworten schreibt. Qwen drei mit vier Milliarden Parametern. Ein Befehl, Ollama pull und 2,5 Gigabyte laufen herunter. Das hat hier knapp fünf Minuten gedauert. Ich spule vor. Zweitens: Ein kleines Modell für die Suche nach Bedeutung. Nomic Embed Text, zweihundertvierundsiebzig Megabyte in unter einer Minute geladen. Es schreibt keine Antworten. Es macht aus Text Zahlen, damit die Demo später auch Fragen mit anderen Worten findet. Ollama List zeigt beide Modelle. Auf Laufwerk D liegen jetzt gut zweieinhalb Gigabyte Modelle. Auf C kommt nichts dazu. Die erste Frage vom Anfang ist damit beantwortet. Die zweite Frage: Wie schnell ist das? Ich stelle dem Modell im Terminal eine erste Frage mit dem Schalter verbose. Dann schreibt Ollama am Ende dazu, wie lange es gerechnet hat. Und weil Qwen drei einen Denkmodus hat, schalte ich ihn ab mit think=false. Und dann das: Das Modell denkt trotzdem. Auf Englisch über achthundert Token lang und erst danach kommt der eine deutsche Satz. Gesamtzeit: drei Minuten und achtundfünfzig Sekunden. Der Prozessor schafft knapp vier Token pro Sekunde. Das Laden selbst dauerte nur neun Sekunden. Der Grund: Hinter dem Namen Qwen drei Komma vier b steckt bei Ollama inzwischen die Thinking-Fassung des Modells. Die denkt immer, der Schalter ändert daran nichts. Ein zweiter Versuch mit no think in der Frage dauerte sogar fast neun Minuten. Die Lösung ist ein anderes Modell. Dieselbe Größe, aber die Instruct-Fassung ohne Denkmodus. Ein weiterer Pull, wieder 2,5 Gigabyte, gut fünf Minuten. Dann dieselbe Frage. Antwort nach siebzehneinhalb Sekunden, davon acht Sekunden laden statt vier Minuten. Für eine Antwort aus der Akte heißt das auf diesem Laptop rund zwanzig bis fünfunddreißig Sekunden warten. Kein Chat zum schnellen Hin und Her. Aber die Akten werden auf diesem Rechner verarbeitet. Und das Wichtigste aus diesem Umweg: Auf einem langsamen Rechner entscheidet die Wahl des Modells mehr als die Hardware. Letzter Schritt: Die Demo neu starten. Vorher stand hier Auszug ohne Sprachmodell, jetzt Ollama lokal Qwen drei Instruct. Im Browser ist der Hinweis auf die Auszüge verschwunden. Erste Frage: Wann ist die Kündigung Herrn Lindqvist zugegangen? Nach einundzwanzig Sekunden die Antwort des Modells. Mit Fundstelle und rechts der markierte Satz im Aktenvermerk. Und der Test noch einmal. Diesmal mit der Vorgabe, dass wirklich das Modell antworten muss. Fünf von fünf. Die Antworten mit Beleg brauchen vierundzwanzig bis vierunddreißig Sekunden. Die Frage nach der Rechtsschutzversicherung null, denn da wird das Modell gar nicht gefragt. An der Dauer siehst du, dass jetzt wirklich ein Modell rechnet. Meine Einschätzung: Eine lokale KI ist heute kein Projekt mehr. Die reine Wartezeit für Download, Installation und Modelle lag hier bei knapp zwanzig Minuten mit dem Umweg über das falsche Modell. Schnell ist so ein Laptop nicht, aber du siehst genau, wo gerechnet wird. Und prüf das Modell, bevor du dich über die Hardware ärgerst. In der nächsten Lektion stellen wir der Akte damit echte Fragen. Mit Fundstelle zu jeder Antwort und mit einem ehrlichen Nein, wenn etwas nicht in der Akte steht. Und jetzt du. Auf welchem Rechner würdest du das zuerst ausprobieren? Schreib es in die Kommentare.
Lektion 2: Aktenfrage mit Fundstellen
Live im Browser: jede Antwort mit Fundstelle, ein Klick öffnet das Dokument an der markierten Stelle, und ein ehrliches „In den Akten nicht gefunden“, wenn nichts trägt. Zum Mitnehmen: vier Prüffragen für jede Kanzlei-KI, egal von welchem Anbieter.
- 00:00Die Frage an die Akte
- 00:31In dieser Lektion
- 01:05Antwort mit Fundstelle
- 03:30In den Akten nicht gefunden
- 04:49Wie die Antwort entsteht
- 06:07Läuft auf einem alten Laptop
- 07:26Wo die Demo an Grenzen stößt
- 08:54Vier Prüffragen
- 09:36Fazit
+Transkript
Ich frage eine Akte: Hat die Mandantin eine Rechtsschutzversicherung? Die meisten KI-Werkzeuge hätten jetzt sofort eine Antwort. Klingt gut, ist schnell und du weißt nicht, woher sie kommt. Zwei Fragen für die nächsten Minuten: Was antwortet eine Kanzlei-KI, wenn die Antwort gar nicht in der Akte steht? Und wie lange braucht das auf einem Laptop von 2016 ohne Grafikkarte und ohne US-Cloud? In dieser Lektion siehst du eine Aktenfrage live im Browser. Jede Antwort kommt mit Fundstelle. Ein Klick öffnet das Dokument an der markierten Stelle. Du siehst, was passiert, wenn nichts in der Akte steht. Du siehst, wie das auf einem alten Laptop läuft und wo die Demo an Grenzen stößt. Am Ende hast du vier Prüffragen, mit denen du jede Kanzlei-KI in fünf Minuten testest. Meine Einschätzung vorweg: Eine Kanzlei vertraut keiner KI, weil sie klug ist. Sie vertraut ihr, wenn jede Aussage einen Beleg hat, den man sofort prüfen kann. Das ist die Demo. Drei Mandate: Mietrecht, Arbeitsrecht und Steuerrecht. Alle Akten sind erfunden. Oben steht immer, wo die Antwort entsteht. Hier lokal auf diesem Rechner. Gerechnet wird mit einem kleinen offenen Sprachmodell über Ollama direkt auf dem Laptop. Wie ich das installiert habe, zeigt die Lektion davor. Erste Frage: Arbeitsrecht. Wann ist die Kündigung Herrn Lindqvist zugegangen? Während die Antwort läuft, spule ich vor. Wie lange das wirklich dauert, zeige ich dir gleich ehrlich. Die Antwort: Die Kündigung ist Herrn Lindqvist am 6. Mai 2026 zugegangen und hinter dem Satz steht eine Nummer. Das ist die Fundstelle. Ein Klick und rechts öffnet sich der Aktenvermerk zum Erstgespräch. Genau an der Stelle, der belegende Satz ist markiert. Du musst der KI nicht glauben. Du liest nach. In zwei Sekunden. Zweite Frage. Eine, die in jeder Kanzlei zählt: Bis wann läuft die Frist für die Kündigungsschutzklage? Antwort: Bis zum 27. Mai 2026, belegt mit demselben Aktenvermerk und als zweiter Beleg die Klageschrift. Die Klage ist innerhalb der Frist erhoben. Jetzt Steuerrecht: Bis wann muss die Bescheinigung des Arbeitgebers beim Finanzamt sein? Spannend, weil das Datum nicht im selben Satz steht. Das Finanzamt schreibt oben: „Bis zum 15. Juni 2026 um folgende Unterlagen." Und erst darunter in der Liste kommt die Bescheinigung. Die Demo markiert beides, den Einleitungssatz mit der Frist und den Listenpunkt. Und Mietrecht: Wie hoch ist die Mietminderung wegen des Schimmels? Zwanzig Prozent der Bruttomiete, zweihundertachtunddreißig Euro im Monat, belegt mit der Mängelanzeige an die Vermieterin. Dazu ein zweiter Beleg: die Antwort der Hausverwaltung. Das Modell schreibt, sie weise die Minderung nicht an. Im Beleg steht: „Eine Mietminderung erkennen wir nicht an." Genau dafür ist die Fundstelle da. Der Wortlaut zählt, nicht die Zusammenfassung. Jetzt die Frage vom Anfang: Hat die Mandantin eine Rechtsschutzversicherung? Und die Antwort lautet: In den Akten nicht gefunden. Das ist kein Fehler. Das ist die wichtigste Antwort in dieser Demo. In der Akte steht nichts zur Rechtsschutzversicherung. Also gibt es keine Antwort. Die Demo rät nicht. Und sie sagt dazu, was sie durchsucht hat, welches Mandat, welche Rolle. Eine KI, die hier höflich etwas erfindet, ist in einer Kanzlei gefährlicher als gar keine. Ein ehrliches Nein erspart dir den Rückruf bei der Mandantin nicht, aber es verhindert, dass du dich auf etwas verlässt, das nie in der Akte stand. Noch ein Nein aus einem anderen Grund. Ich wechsle die Rolle auf den Steuerberater Yilmaz. Er sieht nur das Steuermandat. Dieselbe Frage zur Kündigung wie vorhin: nicht gefunden. Nicht, weil die Akte schweigt, sondern weil diese Rolle das Arbeitsrechtsmandat gar nicht sehen darf. Ehrlich gesagt, das ist hier ein sichtbares Konzept, keine echte Benutzerverwaltung. Aber die Einschränkung sitzt auf dem Server, nicht nur in der Oberfläche. Suche, Antwort und Dokumentansicht sehen nur, was die Rolle sehen darf. Wie kommt dieses Nein zustande? In zwei Stufen. Zuerst sucht die Demo in der Akte. Ganz klassisch, ohne KI. Sie zerlegt jedes Dokument in Abschnitte und prüft, ob die Kernbegriffe der Frage dort vorkommen. Bei der Rechtsschutzversicherung reicht das nicht. Dann wird das Sprachmodell gar nicht erst gefragt. Deshalb kam das Nein auch sofort. Erst wenn die Suche passende Abschnitte findet, bekommt das Modell genau diese Auszüge. Numeriert mit einer festen Regel. Jede Aussage braucht eine Nummer in eckigen Klammern. Steht die Antwort nicht in den Auszügen, sagt es nur: „In den Akten nicht gefunden." Und dann der wichtigste Schritt: Die Demo prüft die Antwort des Modells. Steht keine gültige Nummer darin, wird die Antwort verworfen. Lieber kein Ergebnis als ein unbelegtes. Und eine Überraschung aus meinem Test: Bevor Ollama installiert war, meldete der Test der fünf Beispielfragen: fünf von fünf bestanden. Nur hatte gar kein Sprachmodell geantwortet. Die Demo war auf wörtliche Auszüge ausgewichen und das stand nur klein in der letzten Zeile. Die Antworten stimmten, aber nicht aus dem Grund, den ich prüfen wollte. Deshalb steht oben in der Leiste immer, wo die Antwort entsteht. Die zweite Frage vom Anfang: Wie lange dauert das hier? Dieser Laptop ist ein ThinkPad von 2016 ohne Grafikkarte. Das Modell hat vier Milliarden Parameter und rechnet nur auf dem Prozessor. Eine Antwort braucht hier zwölf bis 35 Sekunden. Die Zeit steht ehrlich an jeder Antwort. Hier gut zwölf Sekunden. Und im Task-Manager siehst du, wie der Prozessor dabei hochfährt. Für die Vorführung habe ich vorgespult. Im Alltag heißt das, eine Tasse Kaffee pro Frage. Dafür werden die Akten auf diesem Rechner verarbeitet. Wer schneller sein will, hat zwei Wege: Ein Kanzleirechner mit Grafikkarte oder eine deutsche Modell API, etwa IONOS in Berlin oder STACKIT. Beide sind in der Demo vorbereitet, aber noch nicht getestet und das steht auch so auf der Folie. Wechseln heißt, eine Zeile in der Konfiguration. Die Oberfläche zeigt dann oben den neuen Betriebsweg. Was ein Betriebsweg berufsrechtlich braucht, Vertrag in Textform nach Paragraf dreiundvierzig e BRAO oder zweiundsechzig a StBerG, Auftragsverarbeitung, Protokolle ist im Einzelfall zu prüfen. Die Demo nimmt dir diese Prüfung nicht ab. Jetzt eine Frage mit anderen Worten. Nicht Mietminderung, sondern: Um wie viel darf Frau Kretschmer die Miete kürzen? Das Modell findet die zwanzig Prozent mit Beleg aus der Mängelanzeige. Ohne Modell hatte die Demo bei dieser Frage nur passende Sätze gezeigt, die zwanzig Prozent fehlten. Aber schau genau hin. Das Modell schreibt: "Frau Kretschmer darf die Miete kürzen." Im Beleg steht etwas anderes. "Wir halten eine Minderung von zwanzig Prozent für angemessen." Das ist eine Einschätzung der Kanzlei, kein Recht, das feststeht. Die KI macht aus einer Einschätzung eine Tatsache. Darum gilt: Die Antwort ist ein Wegweiser, der Beleg ist die Aussage. Genau diese Antworten waren übrigens der Anlass, der Demo nach der Aufnahme eine zusätzliche Regel mitzugeben. Das Modell soll nicht stärker formulieren als der Beleg. Den Klick auf die Fundstelle ersetzt diese Regel nicht. Für solche Fragen gibt es eine zweite Suche über Bedeutung statt Wörter. Das kleine Modell dafür hast du in der Lektion zur Installation gesehen. Und zwei weitere Grenzen nenne ich offen: Die Rollen sind ein Konzept, keine Anmeldung. Und die Demo ist kein Nachweis, dass ein Betriebsweg berufsrechtlich trägt. Sie zeigt, wie es aussehen kann, wenn eine KI belegen muss, was sie sagt. Was nimmst du mit? Vier Prüffragen, mit denen du jede Kanzlei KI testest, egal von welchem Anbieter. Erstens: Zeigt sie zu jeder Aussage die Fundstelle und öffnet ein Klick das Dokument an genau dieser Stelle? Zweitens: Sagt sie "nicht gefunden", wenn du etwas fragst, das sicher nicht in der Akte steht? Stell genau so eine Frage, mit Absicht. Drittens: Siehst du, wo die Antwort entsteht, auf deinem Rechner, in Deutschland oder irgendwo anders? Viertens: Sieht jede Rolle nur die Mandate, für die sie freigegeben ist, auch in der Suche, nicht nur in der Anzeige? Die vier Fragen und die Belegregel als Vorlage stehen in der Beschreibung. Meine Einschätzung: Für Kanzleien entscheidet nicht die klügste KI. Es entscheidet die Fundstelle, die jeder in zwei Sekunden prüfen kann und das ehrliche Nein, wenn nichts in der Akte steht. Beides geht schon heute auf einem alten Laptop, ohne dass die Akten in eine US-Cloud wandern. Schnell ist es dort nicht, aber es ist nachprüfbar. Und jetzt du. Welche Frage würdest du deiner Akte als Erstes stellen? Schreib sie in die Kommentare. Die spannendsten probiere ich an den Testakten aus.
Häufige Fragen
+Kann eine KI Kanzleiakten lokal durchsuchen, ohne dass Daten in die Cloud gehen?
Ja. In dieser Demo laufen Suche und Sprachmodell auf dem Kanzlei-Rechner, hier ein ThinkPad von 2016 ohne Grafikkarte. Ollama stellt das Modell qwen3:4b-instruct lokal bereit, die Akten liegen als Textdateien auf der Platte und werden auf diesem Rechner verarbeitet. Wer mehr Leistung braucht, tauscht den Modellbaustein gegen eine deutsche API (IONOS, STACKIT); die Akten bleiben dann auf dem eigenen Rechner, an den Anbieter gehen nur die drei Auszüge der Fundstellen.
+Wie verhindert eine Kanzlei-KI, dass das Sprachmodell Antworten erfindet?
Mit zwei Regeln vor und nach dem Modell. Vorher entscheidet die Suche: Kommen die Kernbegriffe der Frage in keinem Abschnitt ausreichend vor, heißt es „In den Akten nicht gefunden“, und das Modell wird nicht gefragt. Nachher prüft die Demo jede Antwort: Eine Aussage ohne gültige Belegnummer wird verworfen. Die Systemanweisung verbietet Allgemeinwissen und Vermutungen. Den Klick auf die Fundstelle ersetzt keine dieser Regeln, denn der Beleg ist die Aussage.
+Reicht ein alter Laptop ohne Grafikkarte für ein lokales Sprachmodell in der Kanzlei?
Für eine Vorführung und einzelne Aktenfragen ja: Auf dem ThinkPad T460s dauert eine Antwort mit Beleg 12 bis 35 Sekunden, „nicht gefunden“ kommt sofort. Entscheidend ist das Modell: qwen3:4b ist bei Ollama die Thinking-Fassung und brauchte 3:58 Minuten für einen Satz, qwen3:4b-instruct 17,6 Sekunden. Für mehrere Nutzer gleichzeitig braucht es einen Server mit Grafikkarte oder eine deutsche Modell-API. Was deine Kanzlei braucht, klären wir im Erstgespräch.
+Welche lokalen Sprachmodelle darf eine Kanzlei kommerziell nutzen?
Laut Hersteller stehen qwen3:4b-instruct und nomic-embed-text unter Apache 2.0, phi4-mini unter MIT; alle drei erlauben die kommerzielle Nutzung. qwen2.5:3b steht unter der Qwen Research License und scheidet für eine Kanzlei aus. Vor dem Einsatz die Lizenz des konkreten Modells prüfen, denn Ollama bietet unter einem Namen manchmal eine andere Fassung an als erwartet. Die Angaben hier stammen vom 16. Oktober 2026.
+Ist eine lokale Kanzlei-KI berufsrechtlich zulässig?
Die Demo ist kein Nachweis dafür. Ob ein Betriebsweg trägt, etwa mit einem Vertrag in Textform nach § 43e BRAO oder § 62a StBerG bei einem Dienstleister, einer Auftragsverarbeitung und Protokollen, ist im Einzelfall zu prüfen. Ein lokaler Betrieb vermeidet die Weitergabe an einen Dienstleister, ersetzt aber nicht die Prüfung durch die Kanzlei. Im Halbtags-Workshop „Lokale KI in der Kanzlei“ ordnen wir genau diese Fragen, aus Sicht der Technik, nicht als Rechtsberatung.
+Wie prüfe ich eine Kanzlei-KI in fünf Minuten?
Mit vier Fragen, egal von welchem Anbieter. Zeigt sie zu jeder Aussage die Fundstelle, und öffnet ein Klick das Dokument an genau dieser Stelle? Sagt sie „nicht gefunden“, wenn du etwas fragst, das sicher nicht in der Akte steht? Siehst du, wo die Antwort entsteht: auf deinem Rechner, in Deutschland oder irgendwo anders? Sieht jede Rolle nur die Mandate, für die sie freigegeben ist, auch in der Suche, nicht nur in der Anzeige? Dieselben vier Fragen stelle ich im Audit an eine Kanzlei-KI, die schon im Haus ist.

Passt das zu deinem Vorhaben?
André Heiner— GenAI & LLM Expert aus Wiesbaden, tätig im Rhein-Main-Gebiet. Agentic AI, RAG, Workflow-Automatisierung und KI in den Produktivbetrieb. Mehr im KI-Labor.
Kontakt aufnehmenWeiter im KI-Labor
- Open Weights statt Black-Box-API: welche offenen LLMs 2026 wirklich taugen — und wann Self-Hosting lohnt
- Mail-Radar für Kanzleien: Claude sortiert 121 Mails auf die 7, die zählen — jeden Morgen um 7:11
- Open Source vs. Closed: Llama, DeepSeek & Mistral gegen GPT, Claude & Gemini — was der Unterschied wirklich bedeutet