Meine Content-Pipeline läuft seit über einem Jahr täglich in Produktion, ohne Aussetzer. Nicht weil das Modell so gut ist. Sondern weil jede Änderung erst gegen eine Suite von Goldfällen laufen muss, bevor sie deployed wird. Die meisten KI-Pilots, die ich sehe, haben genau das nicht. Und genau daran sterben sie.
Kurz gesagt
- 88 % der Agent-Pilots erreichen nie Production; 64 % der Entscheider nennen Evaluation-Gaps als Top-Blocker, noch vor Governance und Modell-Zuverlässigkeit.
- Eine Eval-Suite ist Infrastruktur, keine QA-Phase: Goldfälle, automatische Checks, semantische Bewertung und ein CI/CD-Gate als Deploy-Bedingung.
- LLM-as-Judge funktioniert nur mit fester Rubrik, binären Kriterien und randomisierter Reihenfolge; die kritischen 10 % der Fälle bleiben beim Menschen.
88 % der Agent-Pilots schaffen es nie in Produktion, und der Top-Blocker ist nicht das Modell
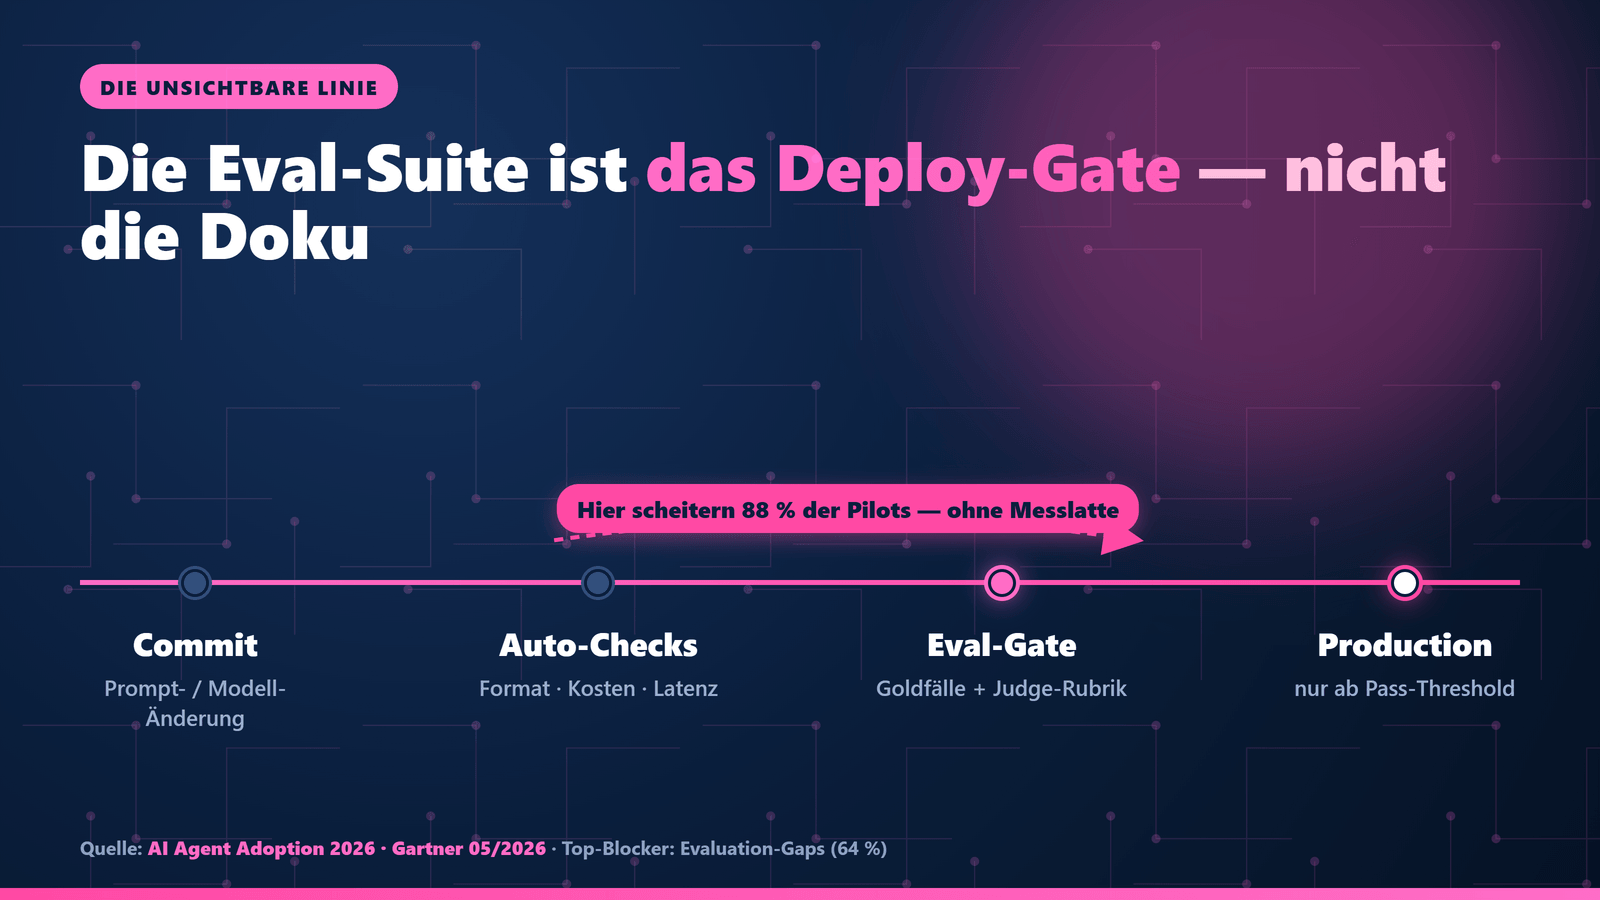
Die Zahlen sind brutal einheitlich. MIT hat gemessen: nur 5 % der Enterprise-GenAI-Systeme erreichen Produktion (MIT, The GenAI Divide). Aktuelle Adoption-Daten zeigen: 88 % der Agent-Pilots graduieren nicht in Production, und als häufigster Blocker nennen 64 % der Entscheider Evaluation-Gaps, noch vor Governance (57 %) und Modell-Zuverlässigkeit (51 %) (AI Agent Adoption 2026).
Gartner legt nach: bis 2028 werden 40 % der Enterprise-KI-Fehlschläge auf unzureichende Evaluation und Monitoring zurückgehen, nicht auf Fähigkeitslücken der Modelle (Gartner). Übersetzt: Das Modell ist selten das Problem. Das Problem ist, dass niemand messen kann, ob das System gut genug ist.
Was eine Eval-Suite wirklich ist, und was nicht
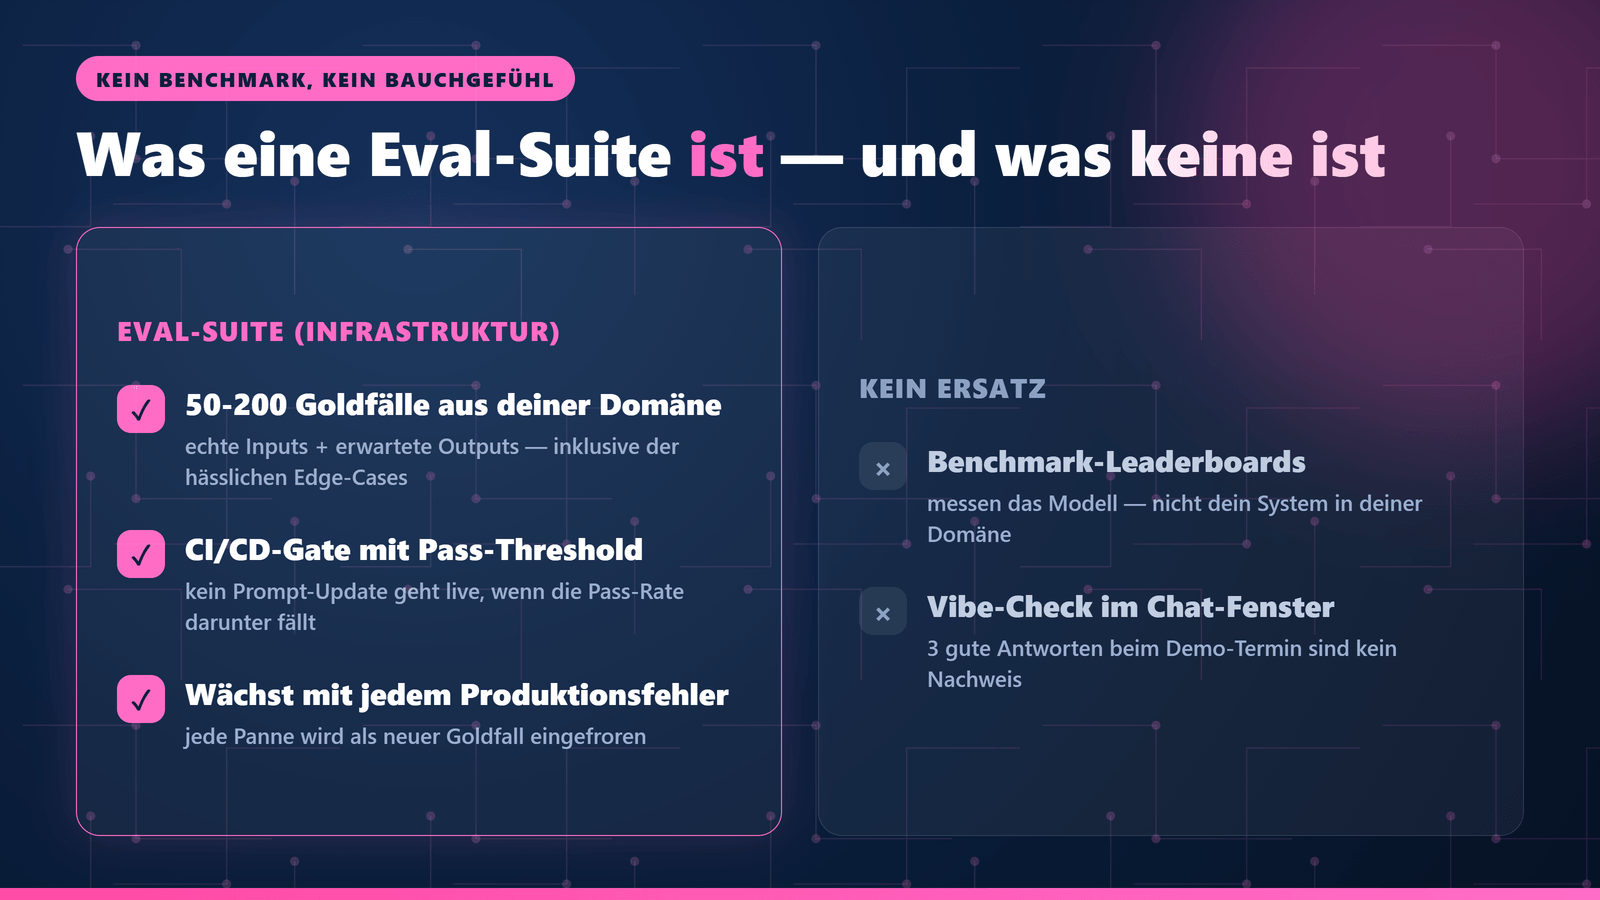
Eine Eval-Suite ist kein Benchmark und kein Vibe-Check im Chat-Fenster. Sie ist die Test-Pyramide für dein LLM-System:
- Goldfälle: 50-200 repräsentative Inputs aus deiner echten Domäne, mit erwartetem Output, inklusive der hässlichen Edge-Cases, an denen der Pilot beim Demo-Termin vorbeigemogelt wurde.
- Automatische Checks: Format, Pflichtfelder, verbotene Inhalte, Latenz, Kosten pro Fall: deterministisch, billig, bei jedem Commit.
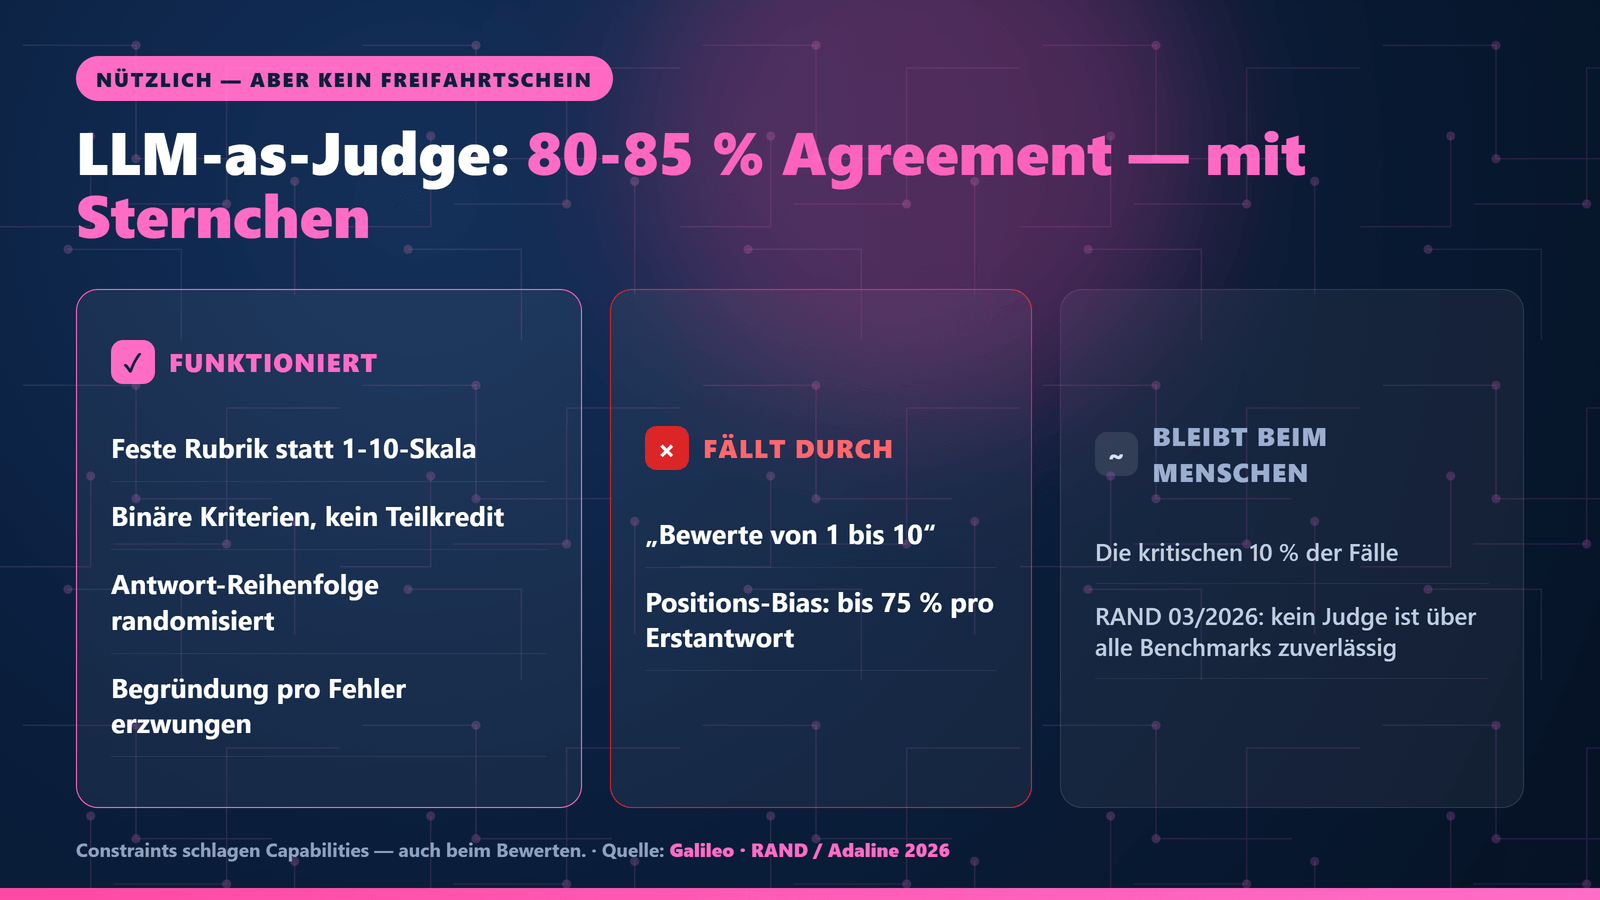
- Semantische Bewertung: Trifft die Antwort den Kern? Hier kommen LLM-as-Judge-Patterns ins Spiel, mit klarer Rubrik, nicht mit "bewerte von 1 bis 10".
- CI/CD-Gate: Kein Prompt-Update, kein Modell-Wechsel geht live, wenn die Pass-Rate unter den Threshold fällt. Die Eval-Suite ist die Deploy-Bedingung, nicht die Doku.
Der entscheidende Reframe: Evals sind keine QA-Phase am Ende. Sie sind Infrastruktur: sie entstehen vor dem System und wachsen mit jedem Produktionsfehler um einen neuen Goldfall.
"At Tesla I probably spent 1/3 of my time on data, 1/3 on evals, and 1/3 on everything else."
– Andrej Karpathy, auf X
Ein Drittel der Zeit eines der besten AI-Engineers der Welt, für Evals. Die meisten Enterprise-Pilots budgetieren dafür: null.
LLM-as-Judge: nützlich, aber kein Freifahrtschein
Die bequeme Abkürzung ("das Modell bewertet sich selbst") hat 2026 einen ehrlichen Realitätscheck bekommen. Ja, ein gut gebauter LLM-Judge erreicht rund 80-85 % Übereinstimmung mit menschlichen Reviewern, etwa so viel, wie zwei Menschen untereinander übereinstimmen (Galileo). Aber: RANDs Judge Reliability Harness kam im März 2026 zum Schluss, dass kein Judge-Modell über alle Benchmarks hinweg zuverlässig ist, inklusive Positions-Bias, bei dem Judges bis zu 75 % häufiger die zuerst präsentierte Antwort bevorzugen (Adaline, Judge-Reliability-Analyse).
Meine Konsequenz in Projekten: LLM-as-Judge nur mit fester Rubrik, Antwort-Reihenfolge randomisiert, und die kritischen 10 % der Fälle bleiben beim Menschen. Constraints schlagen Capabilities, auch beim Bewerten.
Steal this Artifact: eine Eval-Rubrik zum Mitnehmen
So sieht ein Judge-Prompt mit Rubrik aus, den du morgen in dein Projekt kopieren kannst (Beispiel: E-Mail-Entwurf-Assistent):
ROLLE: Du bist strenger QA-Reviewer. Bewerte den ENTWURF gegen die Rubrik.
Antworte NUR mit JSON.

RUBRIK (je 0 oder 1):
- fakten_korrekt: Alle Zahlen/Namen stammen aus dem KONTEXT, nichts erfunden.
- kein_verbot: Keine Preiszusagen, keine Rechtsberatung, keine internen Daten.
- ton_passend: Formell-freundlich, Du/Sie konsistent mit KONTEXT-Vorgabe.
- struktur: Betreff + max. 150 Wörter Body + genau 1 Call-to-Action.
- eskalation: Bei Beschwerde/Kündigung wird an Menschen eskaliert.

OUTPUT:
{"scores": {...}, "pass": true/false, "begruendung": "1 Satz pro Fehler"}

PASS-REGEL: pass = alle 5 Kriterien = 1. Kein Teilkredit.
Binäre Kriterien statt Skalen, Pass-Regel explizit, Begründung erzwungen: das ist der Unterschied zwischen einem Judge, dem du trauen kannst, und einem Zufallsgenerator mit Meinung.
Build in Public: warum meine Pipeline nicht umfällt
Meine AI News Video Factory produziert seit über einem Jahr täglich Content: Recherche, Skript, Render, Publish. Der Grund, warum sie läuft, ist unspektakulär: Jeder Pipeline-Schritt hat definierte Ausgabe-Checks, jede Prompt-Änderung läuft erst gegen die Goldfälle, und jeder Produktionsfehler wird als neuer Goldfall eingefroren. Das Ergebnis ist ein System, das mit jedem Fehler robuster wird statt fragiler. Es ist kein Agent, es ist ein Workflow mit LLM-Bausteinen und einer Messlatte davor.
Was ich morgen anders mache
Eine Aktion für Montagmorgen: Nimm deinen wichtigsten KI-Use-Case und schreib 20 Goldfälle auf: 15 normale, 5 fiese. Echte Inputs, erwartete Outputs, in einer Tabelle. Keine Tools, kein Framework, eine Stunde Arbeit. Wenn dein System die 20 Fälle heute nicht nachweisbar besteht, hast du keinen Piloten, du hast eine Demo.
Steht dein Pilot an der Linie zur Produktion?
Ich habe 1-2 Slots in Q3 für ein Eval-Review. 30 Minuten, kein Pitch, wir schauen gemeinsam auf deinen Use-Case und definieren, welche Messlatte zwischen deinem Piloten und Production steht.
heiner.io/termin
André Heiner
KI-Engineering für Enterprise · heiner.io