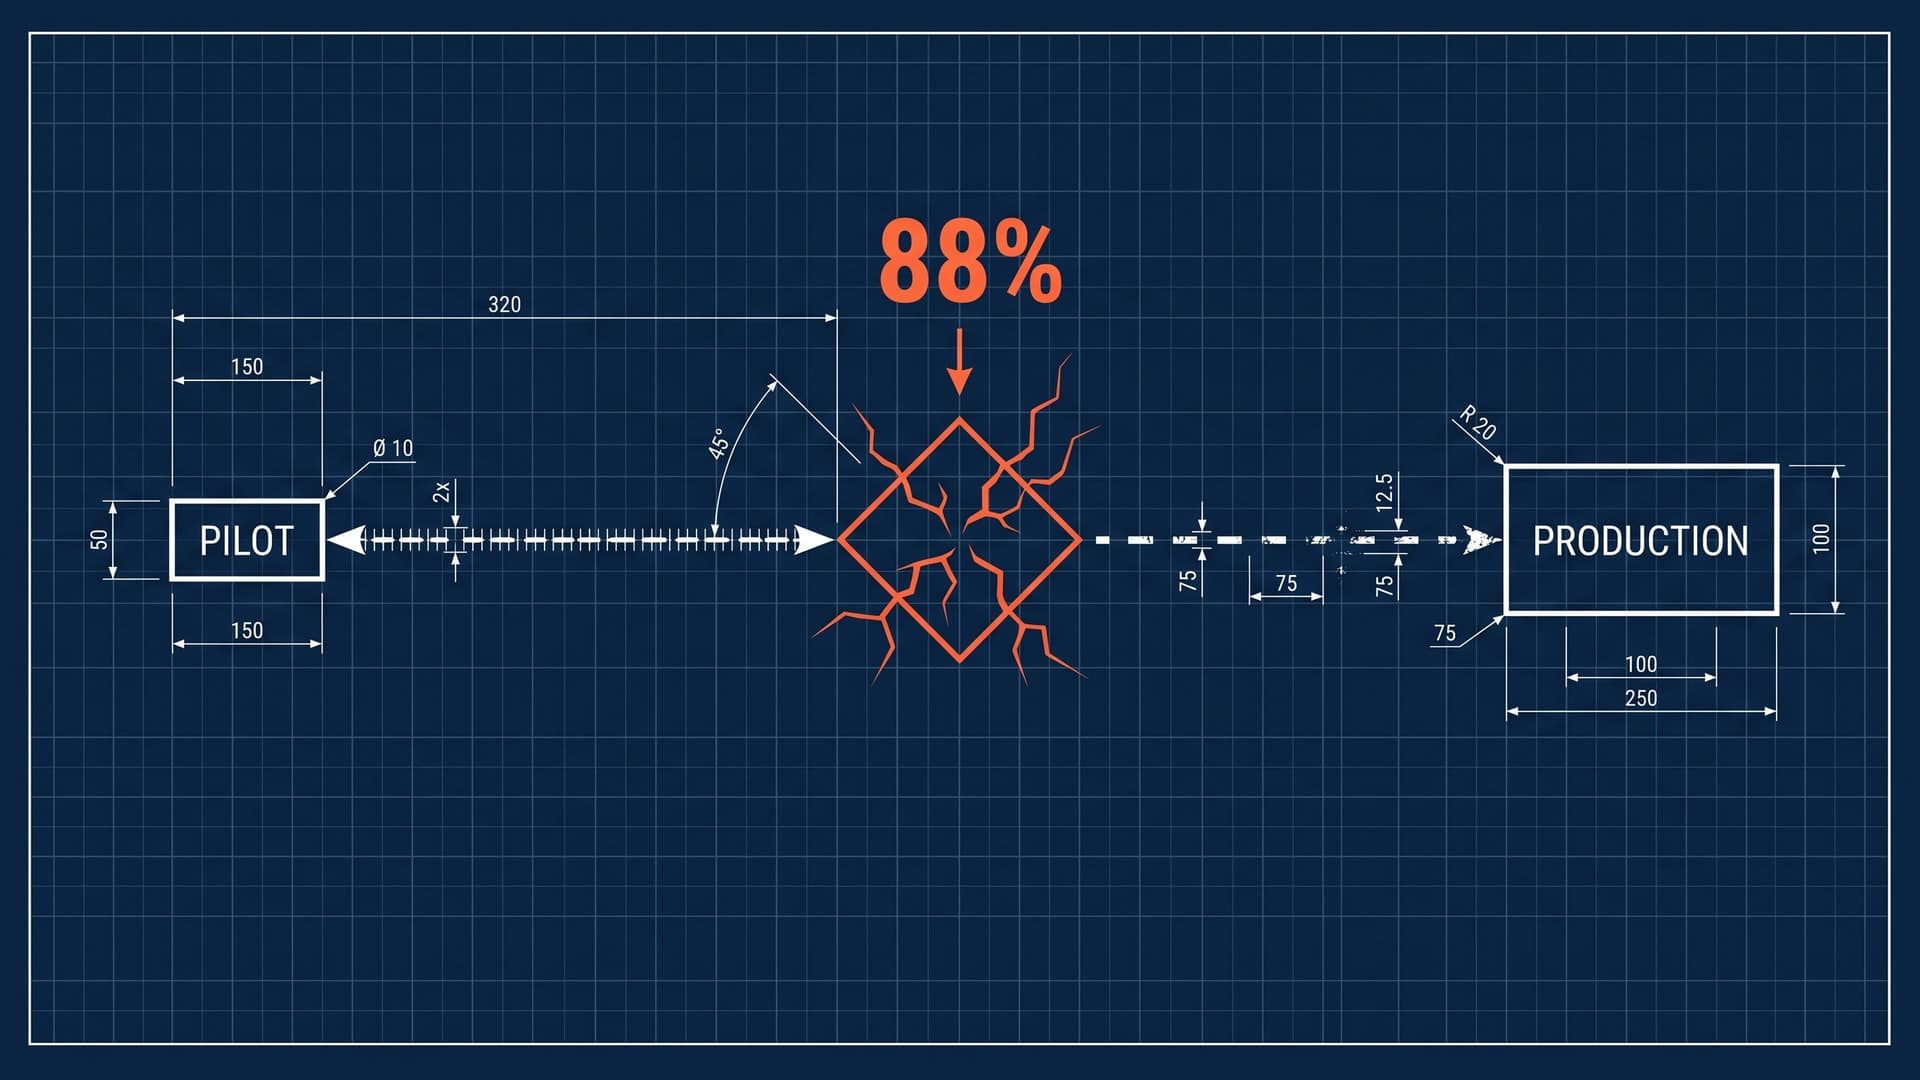
Bain, BCG und McKinsey veröffentlichen gerade neue Studien zum 88%-Problem der KI-Pilots. Alle drei verkaufen dir anschließend die Lösung als sechsstelliges PowerPoint-Programm.
Ich schreib dir heute, was wirklich dahintersteckt. Und du kannst es am Montag selbst angehen.
Kurz gesagt
- Die 88-%-Zahl stammt nicht aus einer Studie, sondern aus dreien (IDC/Lenovo, MIT NANDA, Gartner), mit drei Methoden, die alle in dieselbe Richtung zeigen.
- Deutschland experimentiert überdurchschnittlich (7,5 % aller globalen LLM-Tokens) und skaliert unterdurchschnittlich: wir stecken im Pilot-Modus fest.
- Die Production-Realität heißt nicht Agent, sondern Workflow mit LLM-Bausteinen. Und vor jedem Pilot stehen drei Fragen: Kosten-Baseline, Eskalation, Eval-Suite.
Die drei Studien, die niemand auseinanderhält
Wenn du in den letzten drei Wochen auf LinkedIn warst, hast du die Zahl gesehen: 88% aller KI-Pilots erreichen nie Produktion. Meist falsch zitiert als a16z- oder MIT-Studie. Sie ist weder das eine noch das andere.
Es sind drei verschiedene Studien, mit drei verschiedenen Methoden, und alle sagen ungefähr dasselbe:
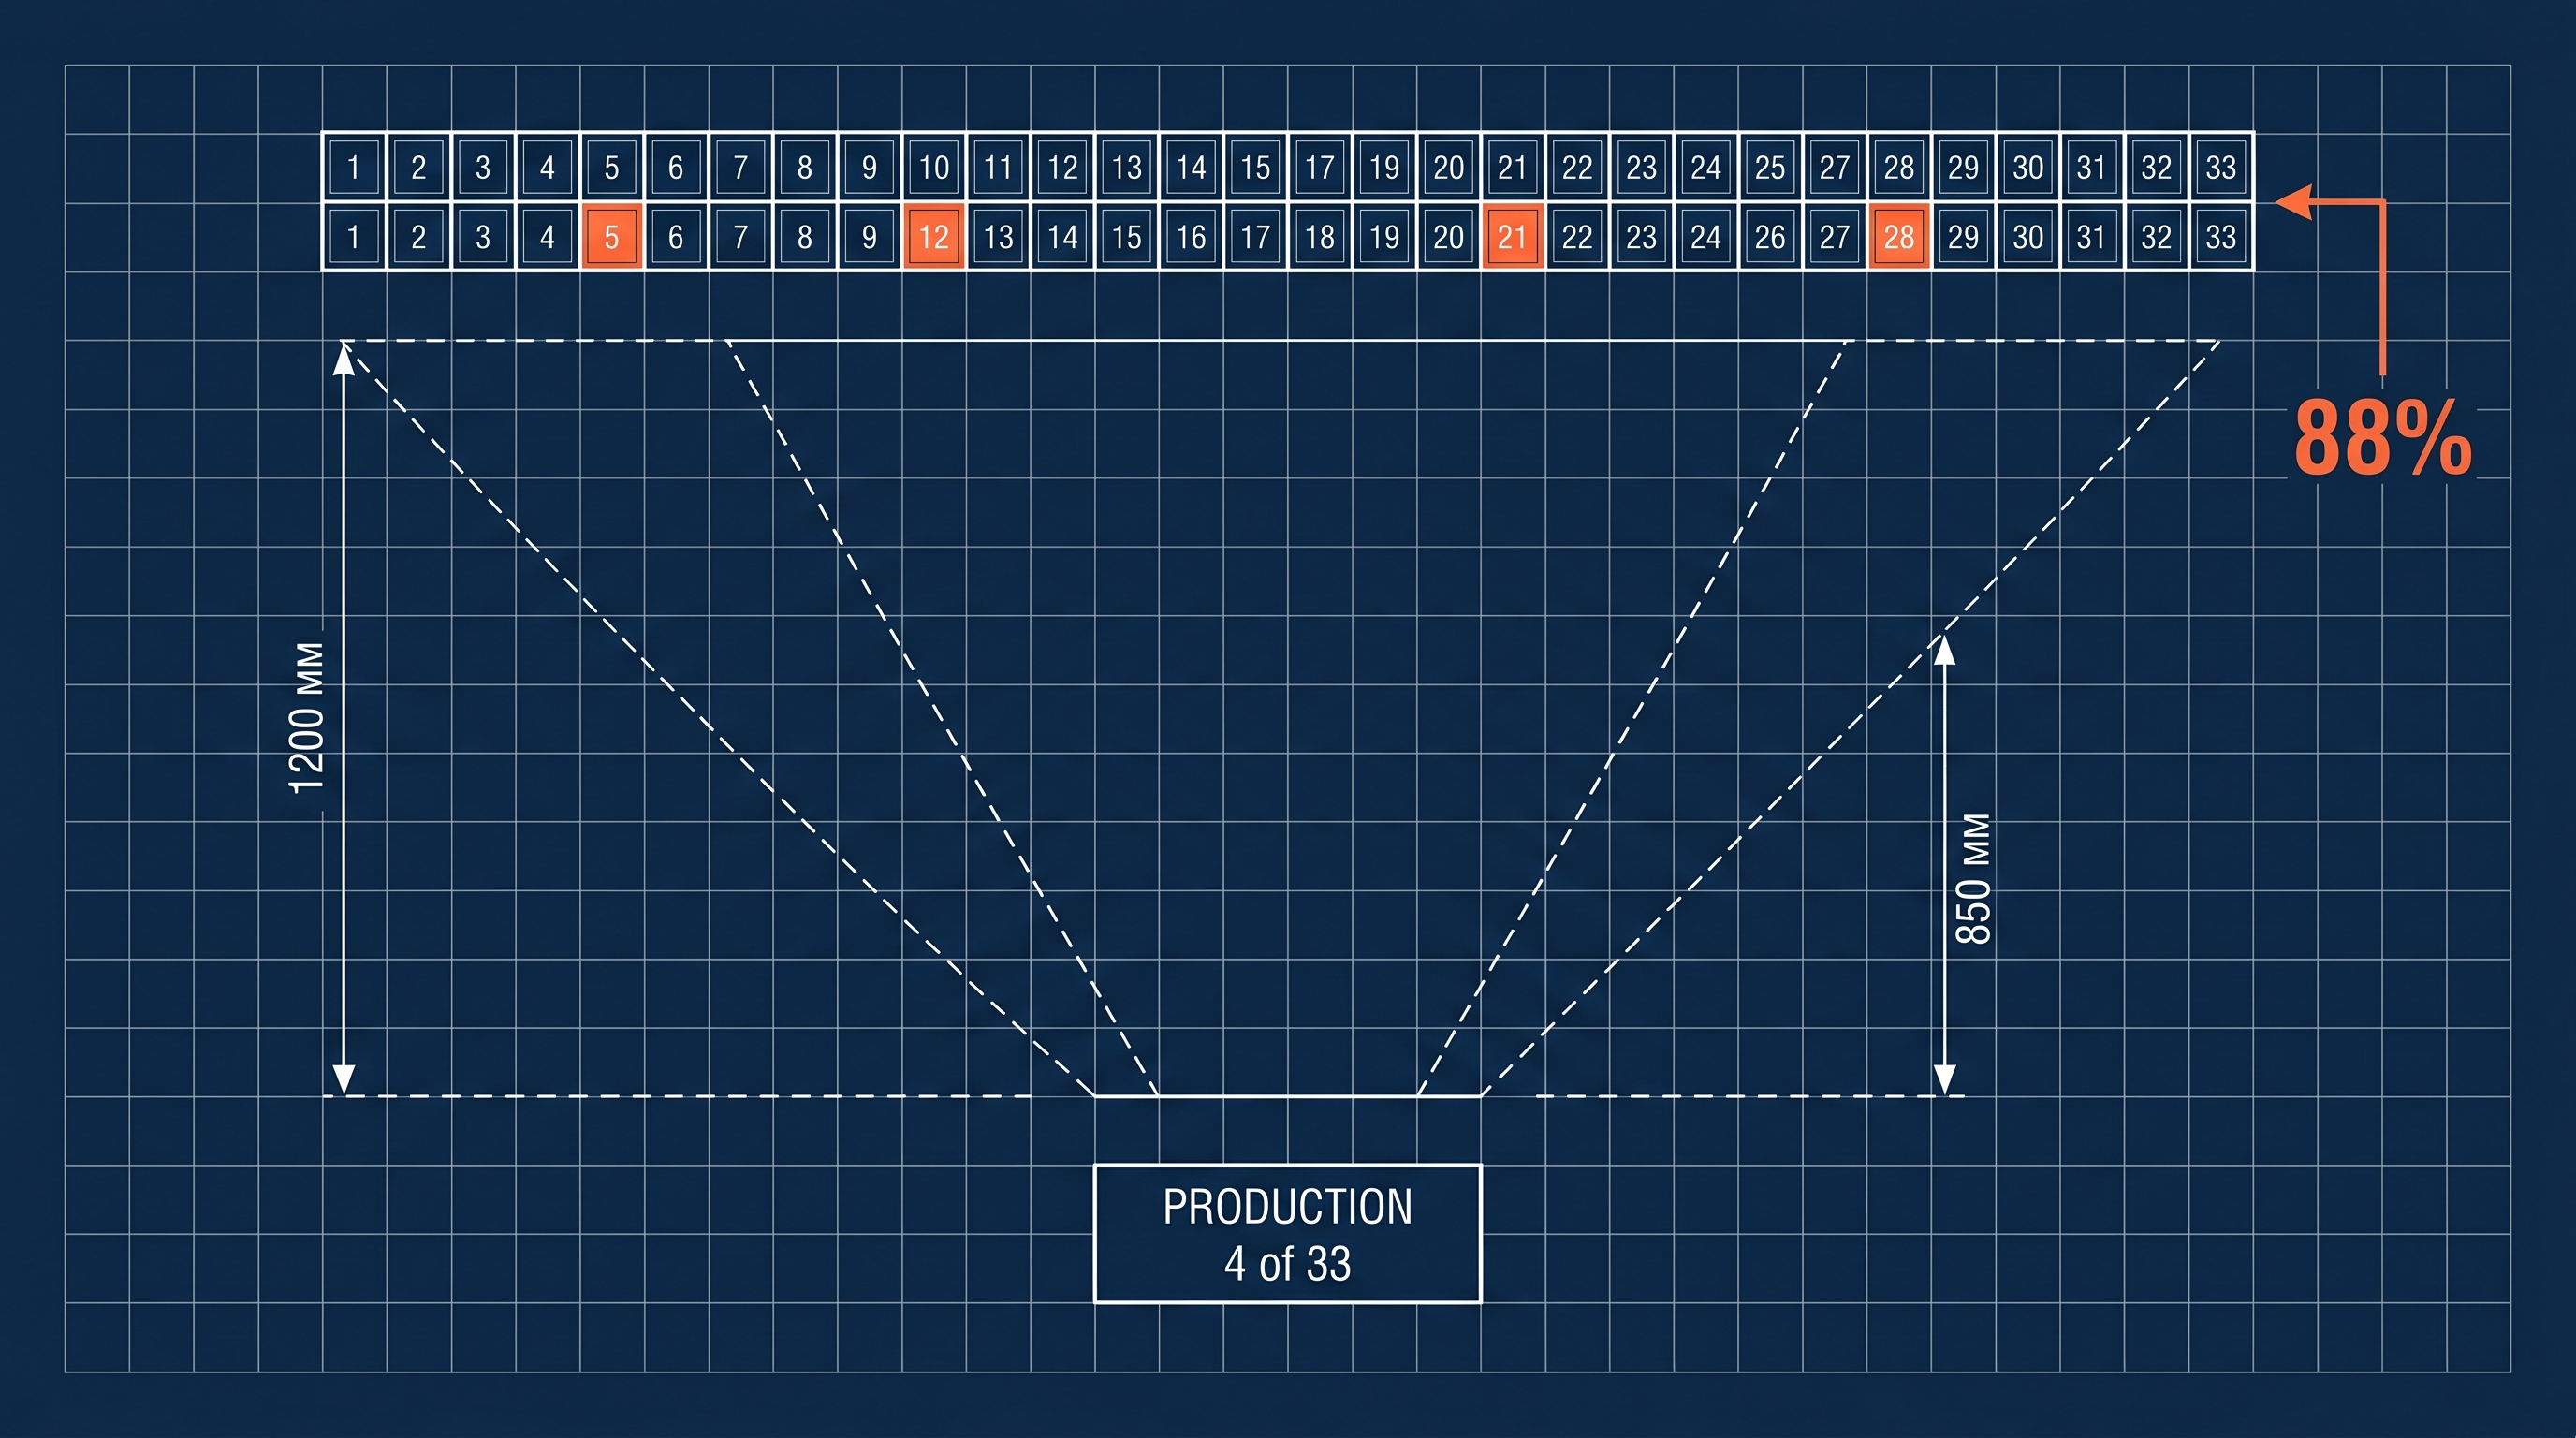
- IDC / Lenovo "AI CIO Playbook 2025": Für jede 33 gestarteten POCs schaffen es 4 in den breitflächigen Einsatz. Das ist die berühmte 88%-Zahl. Methodik: bewusst nicht öffentlich dokumentiert, Sample-Size und Region bleiben Geheimnis. Das ist der größte Schwachpunkt der Zahl.
- MIT NANDA "State of AI in Business 2025": 95% der GenAI-Pilots erzielen keinen messbaren P&L-Impact. Methodik sauber dokumentiert: 150 Leader-Interviews, 350 Mitarbeiter-Surveys, 300 öffentliche Deployments. Wichtigster Sub-Befund: Eingekaufte Vendor-Lösungen schaffen 67% Erfolgsquote, intern gebaute nur 33%.
- Gartner Press Release Juni 2025: 40% der Agentic-AI-Projekte werden bis Ende 2027 gecancelt. Methodik: Webinar-Poll mit 3.412 Teilnehmern, also Selbstauskunft eines Self-Selected-Publikums. Aber: Gartner schätzt nur ~130 von Tausenden Agentic-AI-Vendoren als echt; den Rest nennen sie "Agent Washing".
Drei Studien, drei Methodiken, eine Richtung. Wenn du die Zahl im Vorstand zitierst, weißt du jetzt, welche du meinst.
Was die deutschen Zahlen anders machen
Pip Klöckner hat letzte Woche eine bemerkenswerte Beobachtung publik gemacht: Deutschland steht für 7,5% aller globalen LLM-Tokens, bei einem BIP-Anteil von 4,2%. Wir liegen weltweit auf Platz 3 nach Token-Verbrauch.
Klingt erstmal beeindruckend. Ist es aber nicht, sondern diagnostisch.
Token-Verbrauch ist Forschungs- und Pilot-Workload, nicht Production-Workload. Wir experimentieren überdurchschnittlich. Skalieren tun wir unterdurchschnittlich.
Das passt zur Bitkom-Studie 2026: 41% der deutschen Unternehmen nutzen KI aktiv, aber nur 21% der kleinen Mittelständler (20-49 Mitarbeiter). DIHK kommt auf 20% Mittelstand-Adoption. Jedes dritte Unternehmen sagt: "KI ist teurer als erwartet." Top-Hürde aus der Bitkom: 53% nennen "fehlende Kompetenz", nicht Technologie.
Das ist die deutsche Lage in einem Satz: Wir sind im Pilot-Modus stecken geblieben.
Warum "Agent" das falsche Wort ist
Klarna war 2024 das Lehrbeispiel: AI-Assistant in Production, 2,3 Millionen Conversations im ersten Monat, 700 FTE-Äquivalent eingespart, 40 Millionen Dollar Gewinn-Effekt. OpenAI-Case-Studie, LinkedIn-Hype, Standard-Antwort auf jede CTO-Frage.
Was dann 2025 passierte, hat kaum jemand kommuniziert: Klarna hat den AI-only-Ansatz teilweise zurückgenommen und menschliche Agenten reaktiviert. Nicht weil der Bot schlecht war, sondern weil die Produktion zu absolutistisch designed war. Der Erfolgsfaktor war die Eskalation an Menschen, nicht der Bot allein.
Das ist das Pattern hinter den erfolgreichen 5-12%, die MIT untersucht hat:
- Narrow Scope: ein klarer Use-Case, nicht "Universal-Agent"
- Mensch im Loop mit klaren Eskalations-Pfaden
- Eingebettetes Tool statt grüne Wiese
- Messbare Baseline VOR dem Launch: wer nicht weiß, was die Aufgabe heute kostet, kann den ROI nicht beweisen
Salesforce Agentforce, Bloomberg GPT, Notion AI, Linear AI: alle eingebettete Co-Pilot-Features. Keine autonomen Agenten, die selbständig durch Workflows laufen.
Auch meine eigenen Production-Projekte folgen diesem Muster, meist erst, nachdem wir den "Agent" zerlegt haben.
Die AI News Video Factory haben wir Anfang 2025 zuerst als autonomen News-Curator-Agent gebaut. Ein Multi-Step-LLM-System sollte selbständig Nachrichten finden, bewerten, zu Video-Scripts verarbeiten. Drei Wochen Pilotbetrieb. Ständige Halluzinations-Probleme. Quality-Schwankungen, die das Team nicht beheben konnte.
Die Lösung war banaler als das Marketing: wir haben den "Agenten" in fünf klare Stufen zerlegt. RSS-Ingest, Relevanz-Filter, Faktencheck-Layer, Script-Generation, Video-Render. Jede Stufe deterministisch, das LLM nur an den Stellen drin, wo wirklich Sprache produziert wird. Seit Februar 2025 läuft das System täglich ohne Aussetzer. Es ist kein Agent. Es ist ein Workflow mit LLM-Bausteinen.
Beim Cursor-IDE-Rollout für 150+ Entwickler war es ähnlich: kein eigener Code-Review-Agent, sondern eine Vendor-Lösung mit dünner Governance-Schicht. Quality stieg sofort, weil die Verantwortung klar verteilt war: Cursor übernimmt die Code-Suggestion, der Mensch entscheidet, die Governance-Schicht protokolliert.
"Agent" ist 2026 zum Marketing-Wort geworden. Die Production-Realität ist langweiliger und stabiler: Workflows mit LLM-Bausteinen.
Drei Fragen vor jedem Agent-Pilot
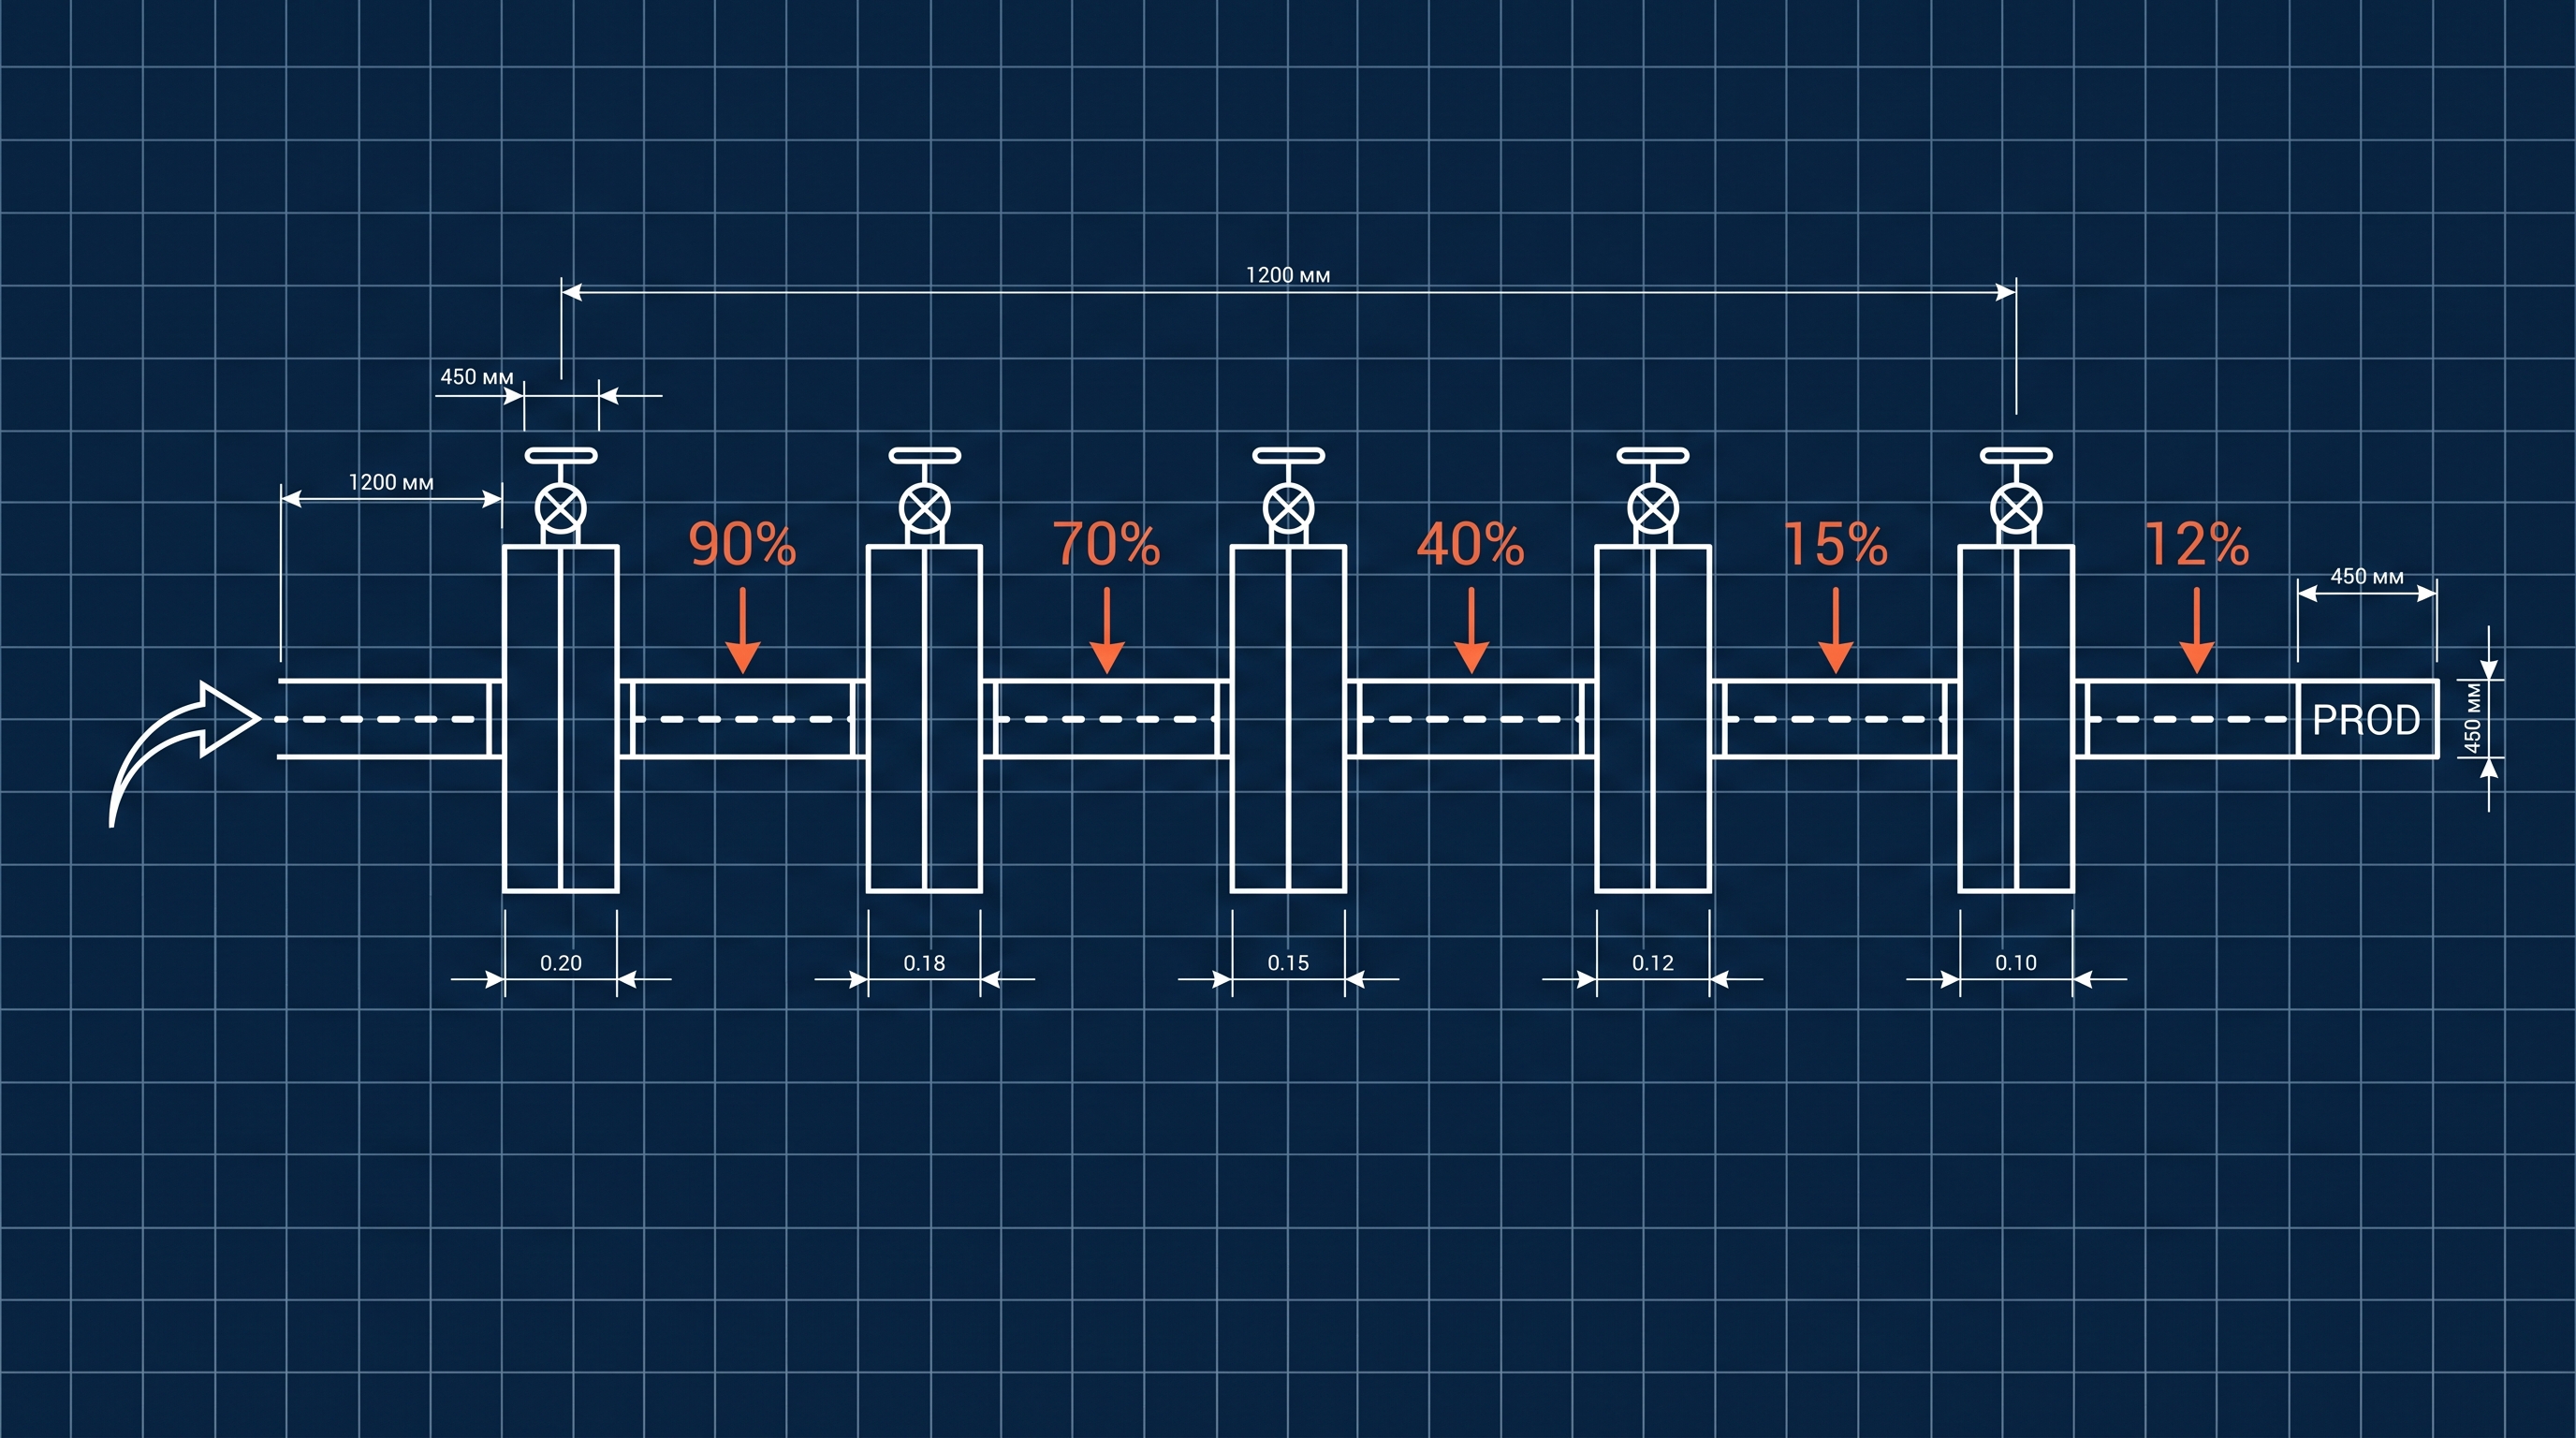
Wenn ich heute mit einem CTO über einen Pilot spreche, stelle ich vor der ersten Codezeile drei Fragen. Wenn auf nur eine davon keine klare Antwort kommt, sollte der Pilot nicht gestartet werden:
Was kostet die Aufgabe heute pro abgeschlossener Einheit, in Euro? Nicht "wir messen Tokens". Sondern: Was kostet eine bearbeitete Beschwerde, eine erstellte Vertragsvorlage, ein generierter Bericht: heute, manuell.
Ein Beispiel aus einem aktuellen Banking-Compliance-Projekt: die Baseline für eine vollständige KYC-Prüfung lag bei rund 47 Euro pro Antrag. Inklusive Sachbearbeiter-Zeit, Tooling, anteilige Audit-Overhead. Bei circa 3.200 Anträgen im Monat sind das 150.400 Euro monatliche Kosten, und damit der Reference-Point, gegen den jeder KI-Agent sich beweisen muss. Ohne diese Zahl gibt es kein ROI-Argument. Mit der Zahl wird die Vorstandsdiskussion in 30 Sekunden geführt.
Welcher Mensch übernimmt, wenn der Agent versagt, und wie eskaliert das Ticket? Nicht im Pilot. In Production. Mit Queue-Logik, Audit-Trail, Service-Level-Vertrag. Klarna hat genau das nachgezogen.
Welche Eval-Suite mit wie vielen Goldfällen läuft in CI? Wenn die Antwort "wir testen manuell" lautet, ist der Pilot bereits tot. Production-LLMs ohne automatisierte Evaluation sind nicht produktiv, sondern produktiv-aussehende Demos.
Diese drei Fragen sind keine Engineering-Spitzfindigkeiten. Sie sind die Pre-Mortem-Checkliste, die in fast jedem gescheiterten Pilot-Postmortem auftaucht, meist als Lücke, nicht als Antwort.
Was ich am nächsten Morgen anders machen würde
Wenn du diese Ausgabe in fünf Minuten gelesen hast und morgen früh ins Büro gehst, ist hier die eine Aktion, die ich dir empfehle:
Schreib auf, was dein aktuell teuerster manueller Prozess pro abgeschlossener Einheit kostet.
Nicht in Aufwandsschätzungen. In Euro pro Output-Einheit. Inklusive Personalkosten, Werkzeug-Lizenzen, anteilige Overhead. Wenn du diese Zahl nicht hast, hast du auch keine ROI-Baseline für irgendeinen KI-Agent.
Das ist die Stelle, an der die meisten Pilots in der Vorstandsdiskussion sterben: nicht im Code, sondern in der Frage "Was bringt uns das in Euro?". Wer die Baseline kennt, kann diese Frage in 30 Sekunden beantworten. Wer sie nicht kennt, verliert das Budget-Gespräch im Q3.
Die 88%-Sterblichkeit ist kein Technologie-Problem. Sie ist ein Diagnose-Problem. Und das lässt sich am Montag angehen.
Wenn du gerade einen Agent-Pilot zwischen "vielleicht in Produktion" und "lieber abbrechen" hast, sprich mit jemandem, der das Pattern schon mehrfach gesehen hat. Aktuell habe ich 1-2 Slots in Q2 2026 frei für Engineering-Reviews.
30 Minuten, kein Pitch, klare Diagnose: heiner.io/termin
Engineering-Patterns im Code (Production-Repos folgen): github.com/banckom
André Heiner
heiner.io · KI-Engineering für Enterprise