Das beste offene KI-Modell der Welt kommt 2026 nicht aus den USA. Es kommt aus China, und es führt den Terminal-Bench 2.x mit ~81 % vor Claude Opus 4.8. Gleichzeitig hat Meta den offenen Frontier aufgegeben. Was das für dein Engineering-Team heißt, und wo Open Weights trotzdem die falsche Wahl sind.
Kurz gesagt
- Die stärksten offenen Modelle kommen 2026 fast alle aus China; Meta hat das offene Frontier verlassen, Mistral hält die EU-Nische.
- Benchmarks ehrlich lesen: auf SWE-bench Pro schrumpft der Abstand zwischen Opus 4.8 und GLM-5.2 auf rund 7 Punkte, den Terminal-Bench führt GLM.
- "Open Weight" ist kein Freifahrtschein: Llama 4 qualifiziert sich nicht als freie Lizenz unter dem AI Act. Default 2026: API-Zugang zu einem offenen Modell, Self-Hosting nur bei Souveränitätszwang.
Die offene Spitze ist 2026 chinesisch
Wer vor zwölf Monaten "Open Source" sagte, meinte Llama. Das ist vorbei.
Die Open-Weight-Landschaft hat sich in der ersten Jahreshälfte 2026 radikal verschoben. Die stärksten offenen Modelle kommen jetzt fast alle aus China: GLM-5.2 (Zhipu, MIT-Lizenz, ~753B/40B MoE, 1M-Kontext) führt den Terminal-Bench 2.x und den Artificial Analysis Intelligence Index. DeepSeek V4 Pro (1,6T/49B, MIT) dominiert beim Reasoning. Kimi K2.7 Code (Moonshot, 1T/32B, Modified-MIT) hat im Juni +21,8 % auf dem Kimi Code Bench v2 gegenüber dem Vorgänger zugelegt und schneidet Thinking-Tokens um 30 % (VentureBeat). Qwen 3.6 (Alibaba, Apache 2.0, 35B-A3B) läuft auf einer einzigen GPU.
Meta hat unterdessen das offene Frontier verlassen: Llama 4 Scout/Maverick erschien im April 2025, aber das Frontier-Modell "Muse Spark" ist geschlossen. Und OpenAIs GPT-5.6, gerade am 9. Juli erschienen, zeigt mit Sol/Terra/Luna eindrucksvoll, was die geschlossene Spitze kann, zu Preisen ab $1/$6 pro 1M Tokens (OpenAI).
Europas Flaggschiff in diesem Feld: Mistral Large 3 (675B/41B MoE, Apache 2.0): aus EU-Jurisdiktion, DSGVO-konform, souverän betreibbar. Kein Leistungs-König, aber der einzige ernsthafte Spieler auf europäischem Boden.
Benchmarks ehrlich lesen
Eine Zahl ohne Kontext ist Marketing. Drei Beispiele:
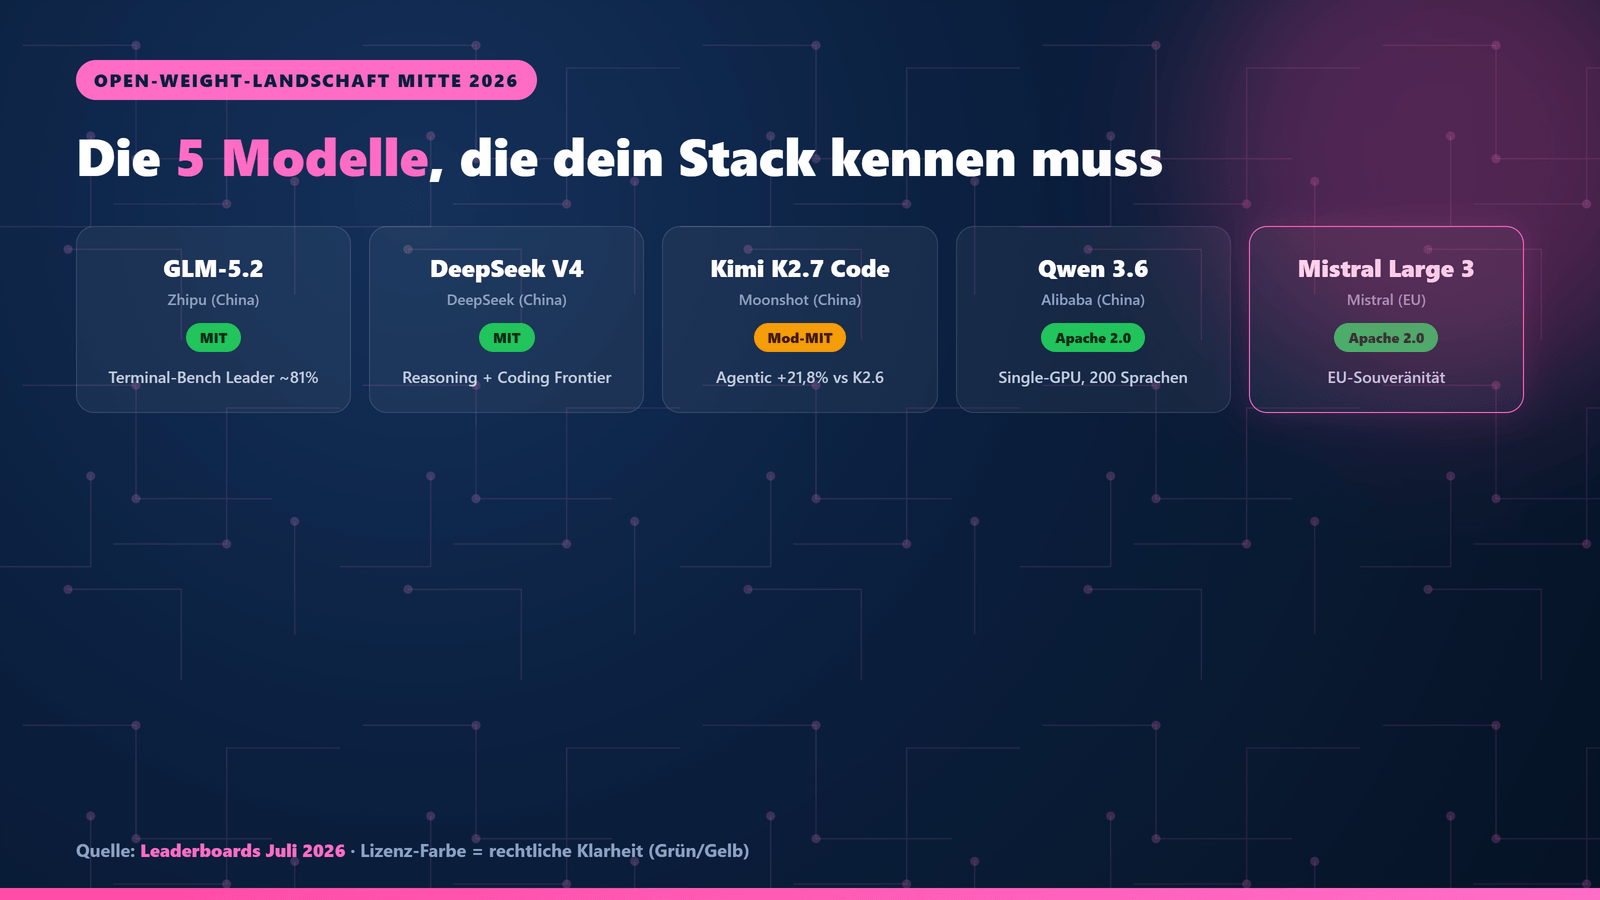
- SWE-bench Verified ist fast gesättigt: Claude Opus 4.8 steht bei ~88,6 %, GLM-5.2 bei ~73 %. Klingt nach Welten. Auf SWE-bench Pro schrumpft der Abstand auf ~7 Punkte (Opus ~69 %, GLM ~62 %).
- Terminal-Bench 2.x (autonome Agenten-Tasks): GLM-5.2 führt mit ~81 %, vor Opus 4.8. Ein Open-Weight-Modell schlägt hier das teuerste geschlossene.
- GPT-5.5 fiel von 55 % auf 23 %, nur weil die Benchmark wechselte.
Die Lektion: Wer dir eine Prozentzahl zeigt, verkauft dir etwas. Bau deinen eigenen Eval-Harness: für deinen Workload, auf deinen Daten.
Steal this: choose_model()
Statt einer Tabelle: eine Entscheidungslogik zum Mitnehmen.
def choose_model(workload, data_sensitivity, budget, gpu_available):
    if data_sensitivity == "eu_strikt" and gpu_available:
        return "Qwen 3.6-35B-A3B"       # Apache 2.0, Single-GPU, 200 Sprachen
    if workload == "terminal_agent":
        return "GLM-5.2"                 # Terminal-Bench-Leader, MIT, ~800 GB VRAM
    if workload == "coding" and budget == "low":
        return "DeepSeek V4 Flash"       # 284B/13B, MIT, on-prem realistisch
    if workload == "agentic_longhorizon":
        return "Claude Opus 4.8"         # SWE-bench Pro Leader, closed
    return "Mistral Large 3"             # EU-Default: Apache 2.0, EU-Jurisdiktion
# vllm serve <model> --tensor-parallel-size N --quantization int4
# Achtung: VRAM-Bedarf VOR Deployment kalkulieren (GLM-5.2 = ~8x H200)
Keine Magie, ein if/elif mit fünf Variablen. Aber es zwingt dich, vor dem API-Call drei Fragen zu beantworten: Wo liegen die Daten? Was ist der Workload? Was darf es kosten?
Die Lizenz-Falle: "offen" heißt nicht "du darfst das"
Ein Absatz, der Geld spart: "Open Weight" ist kein Gütesiegel für rechtliche Freiheit.
- Apache 2.0 / MIT: Frei nutzbar, kommerziell, keine Überraschungen. Qwen 3.6, DeepSeek V4, Mistral Large 3, GLM-5.2: alles sauber.
- Llama 4 Community License: Namensauflagen, 700-Millionen-MAU-Schwelle, EU-Multimodal-Klausel. Das EU AI Office hat im Januar 2026 klargestellt: Diese Lizenz qualifiziert sich nicht als "freie und offene Lizenz" unter dem EU AI Act (Linux Foundation EU). Wer Llama in der EU deployt, bekommt keine Open-Source-Befreiung von den GPAI-Provider-Pflichten.
- Gemma Terms: Google-eigene Bedingungen, nicht Apache, trotz Marketing-Nähe.
Vor jedem Deployment: Lizenztext lesen, nicht README.
Die ehrliche Self-Hosting-Rechnung
Souveräne KI klingt gut. Aber GLM-5.2 braucht ~800 GB VRAM, das sind ~8 H200-GPUs. Rechne mit ~$25.000/Monat Cloud-Kosten für eine einzelne Instanz.
Die andere Seite: Top-Open-Weights kosten via API etwa ein Sechstel der geschlossenen Frontier-Preise. Und Qwen 3.6-35B-A3B läuft auf einer Consumer-GPU mit INT4-Quantisierung.
Der ehrliche Default 2026: API-Zugang zu einem offenen Modell (DeepSeek, Mistral) für den Start. Self-Hosting nur, wenn Datensouveränität es erzwingt oder das Volumen die Fixkosten rechtfertigt.
Souveränität ist kein Buzzword, sie ist Verhandlungsmasse
"Wenn Europa keine souveräne Produktionskapazität in der KI hat, hat es nichts auf den Tisch zu legen gegen die USA. Keine glaubwürdige Drohkulisse, keinen Standard zum Durchsetzen, kein Messer in der Tasche."
– Arthur Mensch, CEO Mistral AI, vor der französischen Nationalversammlung, 13. Mai 2026 (Übersetzung aus dem Französischen)
Mensch redet nicht von Autarkie. Er redet von Verhandlungsfähigkeit. Ein europäisches Team, das auf Mistral Large 3 oder selbst gehostetes Qwen setzt, hat einen Hebel, den ein reines OpenAI-/Anthropic-Setup nicht bietet: die Option, den Anbieter zu wechseln, ohne Daten über den Atlantik zu schicken.
Das ist kein Idealismus. Das ist Risk-Engineering.
Was ich am nächsten Morgen anders mache
Wenn du diese Ausgabe gelesen hast, ist hier die eine Aktion für morgen früh:
Nimm deinen teuersten LLM-Workload und rechne einmal durch:
- Was kostet er heute pro Monat (Token-Volumen x Preis)?
- Was würde derselbe Workload auf dem stärksten offenen Modell kosten, als API, nicht self-hosted?
- Gibt es einen Datensouveränitäts-Grund, der Self-Hosting erzwingt?
In 9 von 10 Fällen wirst du feststellen: Ein offenes Modell deckt den Workload ab, und du sparst zwischen 40 und 85 %. In dem einen Fall, in dem du Claude Opus oder GPT-5.6 Sol brauchst, weißt du danach wenigstens warum.
Wenn du gerade vor der Frage stehst, ob Open Weights, Closed Frontier oder ein Hybrid-Stack für dein Team der richtige Weg ist: ich helfe dir, das in 30 Minuten zu sortieren. Kein Pitch, klare Einordnung, mit TCO-Rechnung.
Aktuell 1-2 Slots in Q3 2026 frei: heiner.io/termin
Beide Labor-Seiten zum Thema stehen auf der Roadmap: /labor/open-llm-souveraenitaet (Vergleich + Architektur-Stack) und /labor/open-llm-lizenzen (Lizenz-Guide mit Verdict-Tabelle). Stay tuned.
Engineering-Patterns im Code: github.com/banckom
André Heiner
heiner.io · KI-Engineering für Enterprise